Cypha / शतरंज
शतरंज खेलिए, सामने है Cypha
Cypha ने शतरंज का कोई खेल कभी देखा ही नहीं। उसने एक आम शतरंज प्रोग्राम को सोचते हुए देखकर सीखा — 26,568 स्थितियाँ, हर एक पर उसी प्रोग्राम का अपना फ़ैसला चिपका हुआ कि कौन जीत रहा है — जब तक Cypha ख़ुद वह फ़ैसला न देने लगा।
नीचे आप उसी से खेलते हैं, जो आपके ब्राउज़र में एक उथली सर्च के भीतर चल रहा है। उसे हराया जा सकता है, और जिस प्रोग्राम से उसने सीखा, उससे वह आज भी हारता है। इस पृष्ठ का हर आँकड़ा उसी प्रशिक्षण रन से निकला है जिसने वे भार बनाए जो यह पृष्ठ लोड करता है।
नीचे दी गई मूल माध्य वर्ग त्रुटि (RMSE) यह नापने का आम तरीक़ा है कि अनुमानों का एक समूह कितना दूर था; यह जितनी छोटी, मॉडल अपने शिक्षक के उतना ही पास।
R² उन रोककर रखी गई स्थितियों पर है जो मॉडल ने फ़िटिंग के दौरान कभी नहीं देखीं। मुक़ाबले की पंक्ति में Cypha सर्च गहराई 2 पर है और शिक्षक इंजन उसी गहराई पर, शुरुआती चालें बेतरतीब और रंग बारी-बारी से। चारों आँकड़े उस मॉडल का ब्यौरा देते हैं जैसा वह डिस्टिल हुआ था — वे तय हैं, और वे आपकी अपनी प्रति की माप नहीं हैं।
यही नतीजा अपेक्षित था और इसे छिपाने के बजाय कह देना ठीक है। संकेत मॉडल की अपनी गहराई-2 सर्च है, जो जमे हुए हेड की अपनी नज़र से मुश्किल से ही गहरी है — ख़ुद से सहमत होना सीखना, मज़बूत होने जैसा नहीं है। जिन 26,568 स्थितियों पर वह डिस्टिल हुआ, उनके सामने एक हज़ार स्थितियाँ कुछ भी नहीं हैं। ईमानदार दावा इतना ही है कि ऑनलाइन लर्नर काम करता है और वही कर रहा है जो वह कहता है; यह दावा कि वह भेजे गए मॉडल को हरा देगा, अभी कमाया नहीं गया है।
यह क्या है, एक मिनट में
कृत्रिम बुद्धिमत्ता (AI) का हर नया डिज़ाइन यह समझाते हुए आता है कि उसे काम क्यों करना चाहिए। वह समझ पढ़ लेने से यह पता नहीं चलता कि वह करता भी है या नहीं। शतरंज इसका फ़ैसला कर देता है, क्योंकि जवाब राय की बात नहीं है: या तो वह समझदार और नियमों के भीतर शतरंज खेलता है, या नहीं खेलता — और आप बैठकर ख़ुद देख सकते हैं।
एक आम शतरंज प्रोग्राम किसी स्थिति को आगे की चालों में खोजकर आँकता है। Cypha को उन्हीं में से 26,568 आकलन दिखाए गए और उन्हें दोबारा बनाने के लिए एक ही फ़ॉर्मूला फ़िट किया गया — बोर्ड को बताने वाले 388 आँकड़ों पर गणित की एक पंक्ति। शतरंज के लिए संरचना में कुछ भी नहीं जोड़ा गया। सिर्फ़ उसमें डाले गए आँकड़े बदले।
वे सब जो Cypha को तौल रहे हैं और बताए जाने के बजाय ख़ुद जाँचना चाहेंगे। मशीन लर्निंग में काम करने वाले लोग, जो देखना चाहते हैं कि इस्तेमाल के दौरान भी कोई मॉडल सीखता कैसे रहता है। और वे सब जिनका बस एक खेल खेलने का मन है — सब कुछ आपके ब्राउज़र में चलता है, और आप जो खेलते हैं वह कहीं नहीं भेजा जाता।
cypha::Cypha — शतरंज हेड सीख रहा है
किसी मोहरे पर क्लिक कीजिए, फिर वहाँ क्लिक कीजिए जहाँ वह जाएगा। जायज़ ख़ाने चिह्नित हैं।
स्थिति
Cypha ने क्या-क्या सोचा
चालें
आपसे सीखना
ड्रिफ़्ट यानी वेट वेक्टर में हुए बदलाव का आकार, डिस्टिल किए गए वेक्टर के मुक़ाबले। आख़िरी सुधार यानी वह जिस स्थिति से अभी चला, उसके बारे में जमा हुआ हेड कितना ग़लत था, प्यादों में, उसकी अपनी गहरी सर्च के मुक़ाबले नापा हुआ।
रेटिंग एक आंतरिक सीढ़ी पर है, Fédération Internationale des Échecs (FIDE) के पैमाने पर नहीं — जिसने कभी किसी रेटेड इंसान से खेला ही नहीं, उस पर FIDE का आँकड़ा चिपकाने का कोई ईमानदार तरीक़ा है ही नहीं। गहराई 1 पर संदर्भ इंजन को 1000 पर बाँधा गया है और बाक़ी सब 210 खेलों से Bradley-Terry अधिकतम संभाव्यता द्वारा फ़िट किया गया है, इसलिए यह इस पर निर्भर नहीं करता कि खेल किस क्रम में खेले गए। नापी हुई सीढ़ी: गहराई 1–3 पर संदर्भ 1000 / 1171 / 1245, Cypha 798 / 1010 / 1161। Cypha जिस इंजन से डिस्टिल हुआ, उससे लगभग एक सर्च-गहराई पीछे चलता है, और त्रुटि-पट्टियाँ मोटे तौर पर ±50 हैं, जो 210 खेलों से इतना ही मिलता है।
हर ताक़त सेटिंग अपने पास रखती है अपना अलग मॉडल। गहराई 1 पर खेलने वाला हेड गहराई-1 की सर्च की ओर सुधारा जाता है; गहराई 3 पर लक्ष्य अलग और बेहतर होता है। दोनों को एक ही वेट वेक्टर में प्रशिक्षित करने से वे आपस में भिड़ जाएँगे। ताक़त बदलिए और उसके साथ गिनतियाँ भी बदल जाती हैं।
कोई इंजन Cypha का मॉडल कैसे बनता है
यह नॉलेज डिस्टिलेशन है, और वही हिस्से इस्तेमाल करके किया गया है जो हर दूसरे Cypha अनुप्रयोग में लगते हैं। संरचना में शतरंज के लिए ख़ास कुछ नहीं जोड़ा गया — सिर्फ़ फ़ीचर।
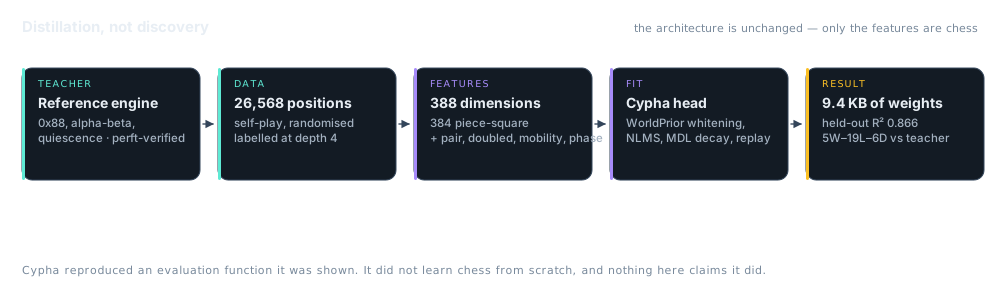
शिक्षक
एक 0x88 इंजन, जिसमें नियमों के भीतर पूरी चाल-उत्पत्ति, सामग्री और piece-square मूल्यांकन, सबसे क़ीमती शिकार – सबसे कम क़ीमती हमलावर (MVV-LVA) क्रम, और शांत-अवस्था सर्च है। kiwipete समेत पाँच मानक perft स्थितियों पर सत्यापित, ताकि उससे कुछ भी सीखने से पहले नियम प्रमाणित रूप से सही हों।
डेटा
स्थितियाँ ख़ुद से खेले गए खेलों से ली गईं, शुरुआती चालें बेतरतीब और शोर जान-बूझकर डाला गया, ताकि सेट किसी एक सँकरी लाइन के बजाय असली खेलों में फैला रहे। हर एक पर शिक्षक का अपना सर्च स्कोर लेबल है, जिसे ±12 प्यादों पर काट दिया गया है, ताकि मात के स्कोर हावी न हो जाएँ।
फ़ीचर
388 विमाएँ: 384-चौड़ा piece-square क़ब्ज़े का अंतर (6 तरह के मोहरे × 64 ख़ाने), साथ में bishop pair, दोहरे प्यादे, गतिशीलता और खेल का चरण। हमेशा उस पक्ष के नज़रिए से जिसकी चाल है, ताकि एक ही वेट वेक्टर दोनों रंगों के काम आए।
फ़िट
WorldPrior θ₀ को Welford से ऑनलाइन फ़िट किया गया, प्राकृतिक-ग्रेडिएंट मापक के रूप में व्हाइटनिंग, सामान्यीकृत न्यूनतम माध्य वर्ग (LMS) भार-अद्यतन, न्यूनतम विवरण लंबाई (MDL) का क्षय जो भारों को वापस प्रायर की ओर खींचता है, और Cypha के संदर्भ 0.30 अनुपात पर एक आश्चर्य-भारित रीप्ले बफ़र।
काम संरचना ने किया, विषय ने नहीं
क़दम 4 का हर हिस्सा एक असली Cypha हिस्सा है, जो अपना असली काम कर रहा है। WorldPrior वही ऑनलाइन गाउसी है जो Cypha पृष्ठ पर मौजूद 2-D क्लासिफ़ायर को उसकी निर्णय सतह देता है। व्हाइटनिंग सूचना-ज्यामिति के दावे को ठोस रूप देती है: अद्यतन कच्चे ग्रेडिएंट के बजाय प्राकृतिक ग्रेडिएंट के साथ चलते हैं। MDL क्षय, Solomonoff पूर्वधारणा को सिकुड़न पद के रूप में कहने का तरीक़ा है।
शतरंज के लिए जो बदला वह है फ़ीचर मैप और हेड — वर्गीकरण की जगह प्रतिगमन। Cypha का README यही दलील देता है कि यह एक ही टाइप है जो कई काम करता है, और इसे ऐसे विषय पर परखा गया है जहाँ जवाब में कोई दुविधा नहीं: या तो यह जायज़, समझदार शतरंज खेलता है या नहीं खेलता।
ईमानदार सीमाएँ
- यह रैखिक है। piece-square फ़ीचर का कोई रैखिक फलन राजा की सुरक्षा, प्यादा-संरचना की आपसी क्रियाओं, या ऐसी किसी भी चीज़ को नहीं दिखा सकता जिसके लिए दो फ़ीचर का गुणनफल चाहिए। इसकी छत वही है जो Cypha का README अनन्य OR (XOR) के लिए बताता है।
- शिक्षक मामूली है। संदर्भ इंजन एक काबिल क्लासिकल सर्चर है, Stockfish नहीं। उसे अच्छी तरह डिस्टिल करने का मतलब है एक मामूली मूल्यांकक से अच्छी तरह मेल खाना।
- इसकी अपनी कोई सर्च गहराई नहीं। यहाँ ताक़त ज़्यादातर alpha-beta रैपर से आती है, ठीक वैसे ही जैसे शिक्षक के मामले में आती है।
- डिस्टिलेशन खोज नहीं है। Cypha ने वह मूल्यांकन फलन दोहराया जो उसे दिखाया गया था। उसने शून्य से शतरंज नहीं सीखा, और इस पृष्ठ पर ऐसा कोई दावा नहीं किया गया।
node tools/chess/perft.js इंजन को मानक परीक्षण स्थितियों के विरुद्ध जाँचता है, और node tools/chess/train.js एक तय बीज से मॉडल को शून्य से दोबारा बनाता है। इस पृष्ठ के ऊपर दिए आँकड़े सीधे उसी रन से बनी फ़ाइल से पढ़े जाते हैं।