Cypha / Échecs
Jouez aux échecs contre Cypha
Cypha n’a jamais vu une partie d’échecs. Elle a appris en regardant un programme d’échecs ordinaire réfléchir — 26 568 positions, chacune étiquetée par le verdict de ce programme sur qui était en train de gagner — jusqu’à savoir produire le verdict elle-même.
Ce contre quoi vous jouez ci-dessous, c’est cela, qui tourne dans votre navigateur au sein d’une recherche peu profonde. Elle est battable, et elle perd toujours contre le programme dont elle a appris. Chaque chiffre de cette page vient de l’entraînement qui a produit les poids que la page charge.
La racine de l’erreur quadratique moyenne (RMSE), ci-dessous, est la mesure habituelle de l’écart d’un ensemble d’estimations ; plus elle est petite, plus le modèle est proche de son maître.
Le R² porte sur des positions réservées que le modèle n’a jamais vues pendant l’ajustement. La ligne de match, c’est Cypha à profondeur de recherche 2 contre le moteur enseignant à la même profondeur, avec ouvertures aléatoires et couleurs alternées. Les quatre chiffres décrivent le modèle tel qu’il a été distillé — ils sont fixes, et ce ne sont pas des mesures de votre copie.
C’est le résultat attendu et il vaut mieux le dire que le cacher. Le signal est la propre recherche du modèle à profondeur 2, à peine plus profonde que la vue de la tête statique elle-même — apprendre à être d’accord avec soi-même n’est pas la même chose que devenir plus fort. Mille positions face aux 26 568 sur lesquelles elle a été distillée, ce n’est rien non plus. L’affirmation honnête, c’est que l’apprenant en ligne fonctionne et fait ce qu’il annonce ; l’affirmation qu’il battra le modèle livré n’est pas méritée.
Ce que c’est, en une minute
Chaque nouvelle conception d’intelligence artificielle (IA) arrive avec une explication de pourquoi elle devrait marcher. Lire l’explication ne dit rien sur le fait qu’elle marche. Les échecs tranchent, parce que la réponse n’est pas affaire d’opinion : ou bien elle joue des coups légaux et sensés, ou bien non, et vous pouvez vous asseoir et le constater.
Un programme d’échecs ordinaire juge une position en explorant les coups à l’avance. On a montré à Cypha 26 568 de ces jugements et ajusté une seule formule pour les reproduire — une ligne de mathématiques sur 388 nombres qui décrivent l’échiquier. Rien n’a été ajouté à l’architecture pour les échecs. Seuls les nombres qu’on lui donne ont changé.
Quiconque évalue Cypha et préfère vérifier plutôt qu’être cru sur parole. Les gens qui travaillent en apprentissage automatique et veulent voir un modèle continuer d’apprendre pendant qu’on s’en sert. Et quiconque a simplement envie d’une partie — tout tourne dans votre navigateur, et rien de ce que vous jouez n’est envoyé nulle part.
cypha::Cypha — tête d’échecs apprentissage
Cliquez une pièce, puis cliquez où elle va. Les destinations légales sont marquées.
Position
Ce que Cypha a envisagé
Coups
Ce qu’elle apprend de vous
L’écart est la taille du changement apporté au vecteur de poids, par rapport à celui qui a été distillé. Dernière correction désigne l’erreur de la tête statique sur la position qu’elle vient de quitter, en pions, mesurée face à sa propre recherche plus profonde.
Le classement est sur une échelle interne, pas celle de la Fédération Internationale des Échecs (FIDE) — il n’y a pas de façon honnête de coller un chiffre FIDE à quelque chose qui n’a jamais joué contre un humain classé. Le moteur de référence à la profondeur 1 est ancré à 1000 et tout est ajusté à partir de 210 parties par maximum de vraisemblance de Bradley-Terry, donc cela ne dépend pas de l’ordre dans lequel elles ont été jouées. L’échelle mesurée : référence 1000 / 1171 / 1245 aux profondeurs 1–3, Cypha 798 / 1010 / 1161. Cypha tourne environ une profondeur de recherche derrière le moteur dont elle a été distillée, et les barres d’erreur sont d’environ ±50, ce que 210 parties vous offrent.
Chaque réglage de niveau conserve son propre modèle. Une tête qui joue à profondeur 1 est corrigée vers une recherche à profondeur 1 ; à profondeur 3, la cible est différente et meilleure. Entraîner les deux dans un seul vecteur de poids ne ferait que les opposer. Changez de niveau et les compteurs changent avec lui.
Comment un moteur devient un modèle Cypha
C’est de la distillation de connaissances, faite avec les mêmes composants que n’importe quelle autre application de Cypha. Rien de spécifique aux échecs n’a été ajouté à l’architecture — seulement les caractéristiques.
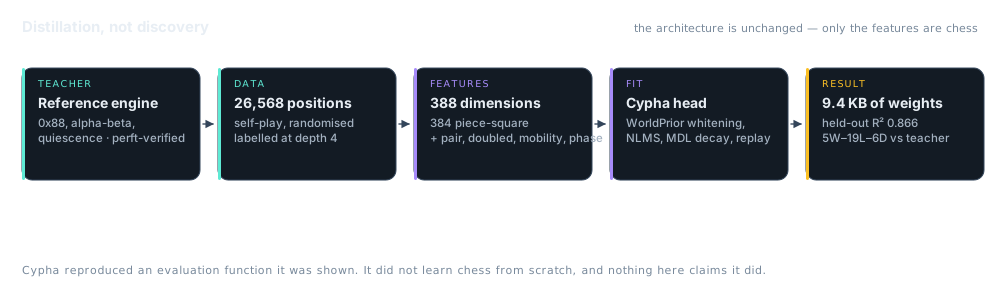
L’enseignant
Un moteur 0x88 avec génération complète des coups légaux, évaluation matérielle et pièce-case, ordonnancement victime la plus précieuse – attaquant le moins précieux (MVV-LVA) et recherche de quiescence. Vérifié sur cinq positions perft standard dont kiwipete, si bien que les règles sont prouvées justes avant qu’on en apprenne quoi que ce soit.
Les données
Des positions tirées de parties contre soi-même, avec ouvertures aléatoires et bruit délibéré, pour que l’ensemble couvre de vraies parties plutôt qu’une seule ligne étroite. Chacune est étiquetée avec le score de recherche de l’enseignant, borné à ±12 pions pour empêcher les scores de mat de dominer.
Les caractéristiques
388 dimensions : une différence d’occupation pièce-case de largeur 384 (6 types × 64 cases) plus la paire de fous, les pions doublés, la mobilité et la phase de jeu. Toujours du point de vue du camp au trait, ainsi un seul vecteur de poids sert les deux couleurs.
L’ajustement
WorldPrior θ₀ ajusté en ligne par Welford, blanchiment comme métrique du gradient naturel, mises à jour de poids par moindres carrés moyens normalisés (LMS), décroissance par longueur de description minimale (MDL) qui ramène les poids vers le prior, et un tampon de rejeu pondéré par la surprise au ratio de référence 0,30 de Cypha.
C’est l’architecture qui a fait le travail, pas le domaine
Chaque composant de l’étape 4 est un vrai composant Cypha qui fait son vrai travail. Le WorldPrior est la même gaussienne en ligne qui donne au classifieur 2-D de la page Cypha sa surface de décision. Le blanchiment, c’est l’affirmation de géométrie de l’information rendue concrète : les mises à jour suivent le gradient naturel plutôt que le gradient brut. La décroissance MDL est le prior de Solomonoff exprimé comme terme de rétrécissement.
Ce qui a changé pour les échecs, c’est la carte de caractéristiques et la tête — régression au lieu de classification. C’est l’argument que le README de Cypha avance sur le fait d’être un seul type qui fait plusieurs travaux, éprouvé sur un domaine où la réponse est sans ambiguïté : soit elle joue des échecs légaux et raisonnables, soit non.
Les limites, honnêtement
- C’est linéaire. Une fonction linéaire de caractéristiques pièce-case ne peut pas représenter la sécurité du roi, les interactions de structure de pions, ni rien qui demande un produit de deux caractéristiques. Elle a le même plafond que celui que le README de Cypha décrit pour le OU exclusif (XOR).
- L’enseignant est modeste. Le moteur de référence est un moteur de recherche classique compétent, pas Stockfish. Bien le distiller revient à bien reproduire un évaluateur modeste.
- Pas de profondeur de recherche propre. Ici, la force vient surtout de l’enveloppe alpha-bêta, exactement comme pour l’enseignant.
- La distillation n’est pas une découverte. Cypha a reproduit une fonction d’évaluation qu’on lui a montrée. Elle n’a pas appris les échecs à partir de rien, et rien sur cette page ne prétend le contraire.
node tools/chess/perft.js vérifie le moteur sur les positions de test standard, et node tools/chess/train.js régénère le modèle à partir de rien avec une graine fixe. Les chiffres en haut de cette page sont lus directement dans le fichier que cette exécution produit.