Une architecture d’IA construite à partir des premiers principes, pas un fork
Presque toute l’intelligence artificielle (IA) moderne est une variation sur les mêmes quelques conceptions. Cypha part d’ailleurs : un seul type C++, avec une règle d’apprentissage tirée des mathématiques plutôt qu’empruntée, qui se met à jour à chaque exemple qu’elle voit au lieu d’être entraînée une fois puis figée. C’est un projet de recherche, et les échecs sont publiés à côté des résultats.
- AIXI / Solomonoff — les priors de longueur de description minimale (MDL) décident ce que le modèle a le droit de croire à bas coût.
- Géométrie de l’information — les mises à jour suivent le gradient naturel, si bien que l’apprentissage respecte la courbure de l’espace des paramètres.
- Inférence active / énergie libre — donne la décomposition structurelle en prior, différentiel et contexte.
- Goulot d’étranglement informationnel — fixe l’objectif de l’encodeur : garder ce qui prédit, jeter le reste.
Ce que c’est, en une minute
Presque tous les systèmes d’IA en service sont une variation sur une poignée de conceptions. Ils sont entraînés une fois sur une grosse machine puis livrés figés, donc suivre quelque chose qui bouge — une nouvelle fraude, une nouvelle panne — oblige à revenir les entraîner. Ils sont aussi gros, ce qui les met dans un centre de données plutôt que sur l’équipement, et rend difficile l’explication de la moindre décision.
Cypha est un seul type C++ qui classe, prédit des nombres et génère des séquences. Sa règle d’apprentissage est dérivée de quatre corpus mathématiques plutôt que copiée sur une architecture existante, et elle se met à jour à chaque exemple qu’elle voit — pas de lot, pas d’époque, pas de réentraînement. Elle est assez petite pour tourner sur le matériel qui collecte les données.
Aujourd’hui, les chercheurs et les ingénieurs prêts à essayer une autre conception. Les problèmes visés sont ceux où les données bougent sans arrêt — fraude, pannes d’équipement, comportements qui changent — où le modèle doit tenir sur l’appareil plutôt que dans un centre de données, et où quelqu’un doit ensuite expliquer la décision.
Des caractéristiques aléatoires, mesurées plutôt que décrites
L’argument de Cypha pour les caractéristiques de Fourier aléatoires (RFF), c’est qu’elles permettent à une tête linéaire de séparer ce qu’une tête linéaire ne peut pas. C’est une affirmation mesurable, donc on la mesure — avec cypha::rff_features compilé en WebAssembly, pas une transposition en JavaScript.
cypha::rff_features — WebAssembly
non chargéeLe noyau exact à fonction de base radiale (RBF) sur n points échantillonnés donne une matrice K. Les caractéristiques aléatoires en reconstruisent une approximation K̂. Ce qui est tracé, c’est ‖K − K̂‖F à mesure que le nombre de caractéristiques augmente : plus de caractéristiques, approximation plus proche.
chi_d de sorte qu’une ligne orthogonale corresponde à la ligne gaussienne qu’elle remplace. Les lignes étaient trop courtes d’un facteur √d, donc les caractéristiques approchaient le mauvais noyau et l’erreur plafonnait au lieu de converger. Une ligne. C’est maintenant la meilleure des trois.
Sept couches, chacune avec un seul rôle
Chaque composant ci-dessous existe parce que l’un des quatre programmes l’exige — pas parce qu’il est apparu dans un article ce trimestre-là.
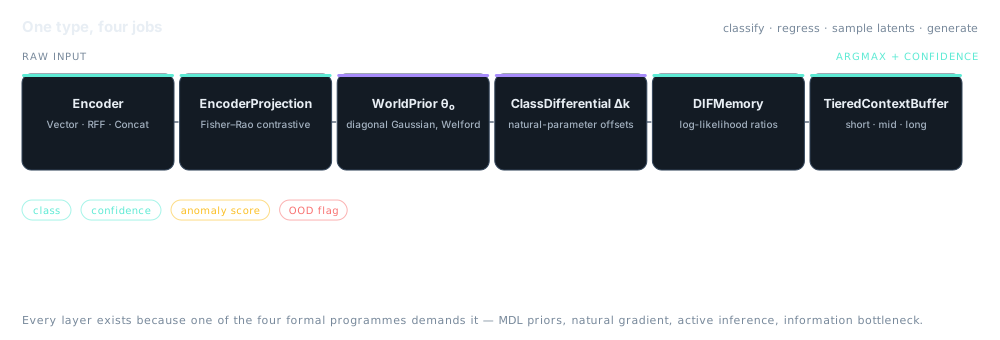
Étage d’entrée interchangeable
De l’entrée brute au vecteur de caractéristiques. Fournit VectorEncoder,
RFFEncoder (caractéristiques de Fourier aléatoires) et ConcatEncoder. Remplacez-le sans toucher à quoi que ce soit en aval.
EncoderProjection
Des caractéristiques vers l’espace latent par mises à jour contrastives de Fisher–Rao, avec plafonnement de la norme de Frobenius pour qu’une seule valeur aberrante ne fasse pas exploser la géométrie.
WorldPrior
Une gaussienne diagonale partagée, ajustée en ligne par Welford et par des mises à jour en moyenne mobile exponentielle (EMA). C’est le “contexte infini” qui n’oublie jamais — et dont le mouvement est le signal de dérive.
ClassDifferential
Des décalages de paramètres naturels par classe, attirés vers les observations et rappelés par la décroissance MDL. Une classe est un déplacement par rapport au monde, pas un modèle à part.
DIFMemory
Calcule des rapports de log-vraisemblance sous des postérieures hyperboliques généralisées, avec des tables de rapports de Bessel pour que les queues lourdes ne coûtent pas une transcendante par échantillon.
TieredContextBuffer
Paliers court, moyen et long pondérés par la confiance NIGField, si bien que les indices récents peuvent dominer sans effacer ce que le palier long a établi.
Entraînez un classifieur au clic
Une miniature 2-D fidèle du pipeline Cypha : un prior du monde ajusté en ligne, des différentiels par classe attirés vers ce que vous placez, et une classification par rapport de log-vraisemblance. Elle apprend de chaque clic — pas de lot, pas d’époque, pas de redémarrage.
cypha::Cypha — classifieur en ligne
Cliquez sur le canevas pour ajouter un échantillon de la classe sélectionnée. Faites glisser pour peindre un groupe.
Classe à placer
Charger un jeu de données
Dernière inférence
Différentiels de classe Δₖ
Résultats, avec la comparaison qui compte
Chiffres issus des propres campagnes de mesure du dépôt, après le correctif de diagnostic. La correction est prouvée par une matrice CTest qui correspond à des références versionnées — pas par une place dans un classement.
Abréviations du tableau : descente de gradient stochastique (SGD), mémoire à court et long terme (LSTM), rétropropagation dans le temps (BPTT).
| Jeu de données | Tâche | Cypha | SGD en ligne | Note |
|---|---|---|---|---|
| Linéairement séparable | 2 classes | 0.783 | 0.644 | Même budget en ligne |
| Iris | 3 classes | 0.900 | — | Jeu de référence classique |
| Wine | 3 classes | 0.969 | — | |
| Digits | 10 classes | 0.922 | — | |
| Breast cancer | 2 classes | 0.957 | — | |
| WikiText-2 | Séquence, 300k jetons | 2,664 BPC | — | Hybride GRIA+LSTM L2+Wave2 BPTT |
| XOR | 2 classes, RFF latent | ~0.763 | — | Le LLR linéaire seul plafonne près du hasard |
À température ajustée, conditionnée par le champ, interpolation de frontière latente, adverse (maximisant l’entropie), échantillonnage OOD, sous contrainte MDL, ancestral, et échantillonnage KDE depuis le tampon de rejeu.
Scores d’anomalie issus des valeurs de porte, scores de requête active comme entropie × proximité de la frontière, et détection de dérive lue directement sur le mouvement du prior du monde.
Un tampon de priorité d’une capacité de 10 000, pondéré par la récence et la surprise, rejoué à un ratio de 0,30 — pour que l’échantillon rare et informatif ne soit pas noyé par le banal.
Profilées, pas devinées
Elles sortent d’une optimisation profilée sur grille moyenne et sont livrées comme configuration de référence.
Ce que Cypha n’est pas
- Pas un habillage. Faite sur mesure à partir des premiers principes — ce qui veut aussi dire qu’elle n’hérite du réglage de personne.
- Le LLR linéaire a un plafond. XOR reste près du hasard sans l’encodeur RFF latent, qui le fait monter à environ 76,3 %.
- La validation repose sur la parité. CTest face à des références versionnées. Aucune revendication de classement n’est faite.
- CUDA sert uniquement à l’inférence. L’entraînement reste sur le processeur central (CPU), parce que sur cette architecture le CPU est plus rapide.
- La théorie est ailleurs. Les travaux sur le spectre harmonique et NMP font l’objet d’un article distinct sur les algorithmes de compression ; Cypha est la couche d’implémentation.
Cypha, distillée depuis un vrai moteur d’échecs
26 568 positions étiquetées avec les évaluations de recherche d’un moteur alpha-bêta classique, ajustées avec le même blanchiment WorldPrior et les mêmes mises à jour par gradient naturel qu’ailleurs dans l’architecture. Elle reproduit l’évaluation de l’enseignant à R² 0,866 sur des positions réservées, et fait 5V–19D–6N contre cet enseignant à profondeur de recherche égale.
Une petite IA qui continue d’apprendre
La plupart des IA sont entraînées une fois dans un centre de données puis livrées figées. Cypha est assez petite pour tourner sur du matériel ordinaire et continue d’apprendre de chaque nouvel exemple qu’elle voit.
Des appareils trop petits pour une grosse IA
Capteurs, caméras, automates et autre matériel qui n’a pas la place d’avoir un centre de données derrière lui. Cypha est assez petite pour tourner sur l’appareil lui-même, donc rien n’a besoin de sortir du bâtiment.
Tout ce qui doit suivre le changement
Schémas de fraude, pannes d’équipement, comportements clients qui bougent. Un modèle entraîné l’an dernier est déjà dépassé. Celui-ci se met à jour au fil de l’eau, sans être retiré du service et réentraîné.
Un travail qu’il faut expliquer après coup
Banques, assureurs et services de santé doivent souvent justifier une décision. Cypha est assez petite pour être inspectée, et elle publie ce qu’elle fait mal au lieu de le cacher.
Trois commandes
$ cmake -S native -B /tmp/cypha_build -DCMAKE_BUILD_TYPE=Release -G Ninja
$ cmake --build /tmp/cypha_build --parallel
$ ctest --test-dir /tmp/cypha_build -R native_ --output-on-failure

# REST service
$ cypha_rest --listen 127.0.0.1:8099 --cypha fixtures/reference.cypha
# Qt shell (build with -DCYPHA_BUILD_QT=ON)
$ cypha_qt_shell