Un modèle de séquences honnêtement moins bon
Un modèle de langage bâti sur un mécanisme complètement différent — plus proche d’une réaction chimique qui se propage sur une surface que des mathématiques de l’attention qu’emploie tout le reste. Il fait moins bien qu’un transformeur, et sa propre page d’accueil le dit. Pas un peu moins bien : quatre ordres de grandeur sur la perplexité (PPL), la mesure standard, face au transformeur génératif pré-entraîné 2 (GPT-2) comme référence, et imprimé sur cette page plutôt qu’en note de bas de page. C’est publié comme un journal de recherche parce qu’un échec documenté vaut quelque chose, et un échec effacé rien.
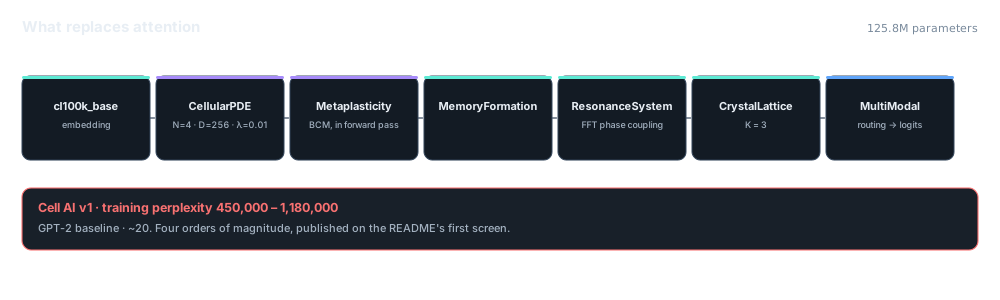
Une perplexité d’entraînement de 450 000 contre 20 pour GPT-2, ce n’est pas passer à côté de peu. C’est quatre ordres de grandeur, et aucune présentation n’y change rien.
La valeur, c’est l’échelle d’expériences E0–E26 avec ses échecs annotés : quelles idées d’architecture se sont effondrées, comment, et ce que disaient les diagnostics. Un résultat négatif avec une cause documentée est une contribution. Un résultat négatif effacé en silence est du travail gâché.
Ce que c’est, en une minute
Presque toutes les IA qui traitent le langage reposent sur la même idée : laisser chaque mot regarder tous les autres mots. Ça marche. Personne ne sait quelle part vient de ce que c’est la meilleure idée disponible et quelle part de ce que c’est celle que tout le monde a essayée.
Cell AI retire cela et met autre chose à la place : deux substances chimiques qui se propagent et réagissent sur une surface, comme se forment les rayures d’un animal, avec des connexions qui changent pendant la lecture plutôt qu’après. Il a ensuite été entraîné à pleine taille et mesuré. Il est ressorti quatre ordres de grandeur moins bon que GPT-2. C’est le titre de cette page, pas une ligne en annexe.
Les chercheurs qui veulent savoir ce qu’il y a au bout du chemin que personne n’a pris. Les scientifiques qui modélisent déjà le vivant, parce que le mécanisme sous-jacent est celui qui fait les motifs en chimie et les marques sur les animaux. Les enseignants, parce que la recherche publiée n’est presque que des succès, et qu’un compte rendu soigneux d’un échec est plus rare et plus utile.
La dynamique sous l’architecture
Ceci est un système de réaction-diffusion de Gray–Scott — la même classe de dynamiques sur laquelle repose le cœur CellularPDE. Deux produits chimiques diffusent à des vitesses différentes et réagissent ; les taux d’apport et de suppression décident si vous obtenez des taches, des rayures, des cellules qui se divisent ou rien du tout. Le pari de l’architecture, c’est que ce genre de champ auto-organisé peut porter du calcul. Regardez-le et jugez vous-même de la plausibilité.
CellularPDE — cœur de réaction-diffusion
Cliquez ou faites glisser sur le champ pour injecter le produit B et perturber le motif.
État des partitions
N = 4 partitions du champ, comme dans le cœur CellularPDE. La hauteur est l’activation moyenne de chaque partition ; la fuite λ = 0,01 les couple.
Gray–Scott avec Da=1.0, Db=0.5, laplacien à neuf points, Euler explicite. Ceci est le substrat dynamique, pas le modèle entraîné — le modèle entraîné fait 125,8 M de paramètres et ne tient pas dans un onglet de navigateur.
CellularPDE est fait. L’architecture elle-même est en PyTorch.
Ce qui remplace l’attention
CellularPDE
N = 4 partitions d’un état de dimension D = 256, fuite λ = 0,01, termes de réaction sigmoïdes — un système de réaction-diffusion discret là où se trouverait l’auto-attention.
MetaplasticityLayer
Apprentissage hebbien à la Bienenstock–Cooper–Munro (BCM), avec α = 0,1, β = 0,01, appliqué pendant la passe avant plutôt qu’après elle. C’est l’idée la plus audacieuse de l’architecture et la source de son problème documenté de famine de gradient.
SpectralPDE & SparseHebbian
SpectralPDE ramène la complexité de O(D²) à O(D log D). SparseHebbian compresse les mises à jour de 65 536 poids à 1 024. MultiScalePartitions fait tourner des flux rapides et lents ; AnnealedRouter utilise un ordonnancement Gumbel-Softmax.
La pile complète
Embedding cl100k_base → CellularPDE → MetaplasticityLayer → MemoryFormation → ResonanceSystem → CrystalLattice (K = 3) → couplage de Kuramoto optionnel → routage MultiModalModel → logits. L’étage de résonance couple les phases par une transformation de Fourier rapide (FFT).
De E0 à E26, échecs annotés
Le programme de recherche d’architecture est ici le véritable artefact. Vingt-sept expériences, chacune avec ce qui a été tenté et ce qui a mal tourné, y compris celles qui ont reculé.
| Constat | Résultat |
|---|---|
| PerFreqResonance | Problèmes documentés, n’a rien donné |
| Routage | S’est effondré en dégénérescence de classes dans certaines configurations |
| E26 vs E25 | Régression — l’expérience la plus récente était moins bonne |
| ResonanceSystem | Contribution au gradient minime |
| Génération (v1) | Pas de véritable échantillonnage autorégressif |
| v3 Cell-Fungal Harmonic | Spéculatif, non intégré |
L’écart, dit simplement
Une tentative de construire l’IA d’une tout autre façon
Presque toutes les IA d’aujourd’hui reposent sur la même idée de fond. Cell AI est une tentative à pleine échelle d’en suivre une autre, empruntée à la façon dont les motifs se forment dans la nature — publiée avec ses échecs intacts.
Chercheurs qui regardent au-delà de l’approche actuelle
Le progrès demande que quelqu’un prenne la route non empruntée et note ce qui s’est passé. C’est cette tentative, en taille réelle, avec les impasses consignées au lieu d’être discrètement abandonnées.
Scientifiques qui modélisent les systèmes vivants
Le mécanisme sous-jacent est celui qui produit les rayures des animaux et les motifs en chimie. Si c’est le monde dans lequel vous travaillez, le modèle parle votre langue.
Enseignants qui veulent un échec honnête
La recherche publiée porte massivement sur ce qui a marché. Ceci est un compte rendu soigné de quelque chose qui n’a pas marché, bien plus utile pour apprendre qu’une réussite de plus.
Où ces idées sont allées à la place
Cell AI est la ligne de recherche qui n’a pas convergé. Ses voisines s’en sont mieux tirées : Cypha est devenue une architecture par premiers principes qui fonctionne, et le travail sur la mémoire à long contexte est devenu Unified Hash-Predictive Memory (UHPM).