Um modelo de sequência que é honestamente pior
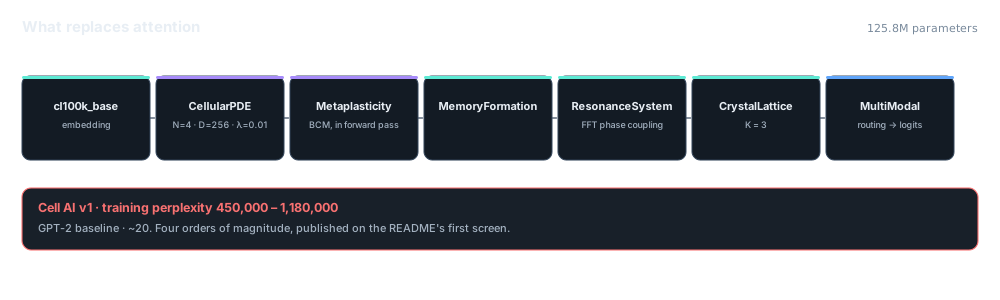
Um modelo de linguagem construído sobre um mecanismo completamente diferente — mais perto de química se espalhando por uma superfície do que da matemática de atenção que todo o resto usa. Ele tem desempenho pior que o de um transformer, e a própria página inicial dele diz isso. Não um pouco pior: quatro ordens de grandeza em perplexidade (PPL), a medida padrão, contra o Transformer Generativo Pré-treinado 2 (GPT-2) como linha de base, e impresso nesta página, não em uma nota de rodapé. É publicado como diário de pesquisa porque uma falha documentada vale alguma coisa e uma falha apagada não vale.
Perplexidade de treino de 450.000 contra os 20 do GPT-2 não é chegar perto. São quatro ordens de grandeza, e nenhum enquadramento muda isso.
O valor está na escada de experimentos E0–E26 com as falhas anotadas: quais ideias de arquitetura desabaram, como, e o que os diagnósticos disseram. Um resultado negativo com causa documentada é uma contribuição. Um resultado negativo apagado em silêncio é trabalho jogado fora.
O que isto é, em um minuto
Quase toda IA que lida com linguagem é construída sobre a mesma ideia: deixar cada palavra olhar para todas as outras. Funciona. Ninguém sabe quanto disso é por ser a melhor ideia disponível e quanto é por ser a que todo mundo tentou.
O Cell AI tira isso e põe outra coisa no lugar: dois químicos se espalhando e reagindo por uma superfície, do jeito que listras se formam em um animal, com as conexões mudando enquanto ele lê, e não depois. Foi então treinado em tamanho real e medido. Saiu quatro ordens de grandeza pior que o GPT-2. Essa é a manchete desta página, não uma linha em um apêndice.
Pesquisadores que querem saber o que acontece no caminho que ninguém pegou. Cientistas que já modelam sistemas vivos, porque o mecanismo por baixo é o mesmo que faz padrões na química e marcas em animais. Professores, porque a pesquisa publicada é quase toda de sucessos, e um relato cuidadoso de um fracasso é mais raro e mais útil.
A dinâmica por baixo da arquitetura
Este é um sistema de reação-difusão de Gray–Scott — a mesma classe de dinâmica sobre a qual o núcleo CellularPDE é construído. Dois químicos se difundem a taxas diferentes e reagem; as taxas de alimentação e de remoção decidem se você obtém manchas, listras, células se dividindo ou nada. A aposta da arquitetura é que um campo auto-organizado desse tipo consegue carregar computação. Observe e julgue a plausibilidade você mesmo.
CellularPDE — núcleo de reação-difusão
Clique ou arraste no campo para injetar o químico B e perturbar o padrão.
Estado das partições
N = 4 partições do campo, como no núcleo CellularPDE. A altura é a ativação média de cada partição; o vazamento λ = 0,01 as acopla.
Gray–Scott com Da=1.0, Db=0,5, laplaciano de nove pontos, Euler explícito. Este é o substrato dinâmico, não o modelo treinado — o modelo treinado tem 125,8 mi de parâmetros e não cabe numa aba de navegador.
CellularPDE é feito. A arquitetura em si é PyTorch.
O que substitui a atenção
CellularPDE
N = 4 partições de um estado de dimensão D = 256, vazamento λ = 0,01, termos de reação sigmoide — um sistema de reação-difusão discreto no lugar onde estaria a auto-atenção.
MetaplasticityLayer
Aprendizado hebbiano no estilo Bienenstock–Cooper–Munro (BCM), com α = 0,1, β = 0,01, aplicado durante a passagem para frente, e não depois dela. Esta é a ideia mais ousada da arquitetura e a origem do seu problema documentado de fome de gradiente.
SpectralPDE e SparseHebbian
O SpectralPDE corta a complexidade de O(D²) para O(D log D). O SparseHebbian comprime as atualizações de 65.536 pesos para 1.024. O MultiScalePartitions roda fluxos rápido e lento; o AnnealedRouter usa agendamento Gumbel-Softmax.
A pilha completa
Embedding cl100k_base → CellularPDE → MetaplasticityLayer → MemoryFormation → ResonanceSystem → CrystalLattice (K = 3) → acoplamento Kuramoto opcional → roteamento MultiModalModel → logits. O estágio de ressonância acopla fases com uma Transformada Rápida de Fourier (FFT).
De E0 a E26, com as falhas anotadas
O programa de busca de arquitetura é o artefato de verdade aqui. Vinte e sete experimentos, cada um com o que foi tentado e o que deu errado, incluindo os que andaram para trás.
| Achado | Desfecho |
|---|---|
| PerFreqResonance | Problemas documentados, não entregou |
| Roteamento | Desabou em degenerescência de classes em algumas configurações |
| E26 vs. E25 | Regressão — o experimento mais recente foi pior |
| ResonanceSystem | Contribuição mínima de gradiente |
| Geração (v1) | Falta amostragem autorregressiva de verdade |
| Cell-Fungal Harmonic da v3 | Especulativo, não integrado |
A diferença, dita sem rodeios
Um experimento de construir IA de um jeito completamente diferente
Quase toda IA hoje é construída sobre a mesma ideia de base. O Cell AI é uma tentativa em escala plena de outra ideia, emprestada de como os padrões se formam na natureza — publicada com as falhas intactas.
Pesquisadores olhando além da abordagem atual
O progresso precisa de alguém que tente o caminho não tomado e escreva o que aconteceu. Esta é essa tentativa, em tamanho real, com os becos sem saída registrados em vez de descartados em silêncio.
Cientistas que modelam sistemas vivos
O mecanismo por baixo é o mesmo que produz listras em animais e padrões na química. Se esse é o mundo em que você trabalha, o modelo fala a sua língua.
Professores que querem um fracasso honesto
A pesquisa publicada é esmagadoramente sobre coisas que deram certo. Este é um relato cuidadoso de algo que não deu, o que é muito mais útil para aprender do que mais um caso de sucesso.
Para onde essas ideias foram em vez disso
O Cell AI é a linha de pesquisa que não convergiu. As irmãs se saíram melhor: o Cypha virou uma arquitetura de princípios básicos que funciona, e o trabalho de memória de contexto longo virou a Memória Unificada Hash-Preditiva (UHPM).