Un modelo de secuencia que es honestamente peor
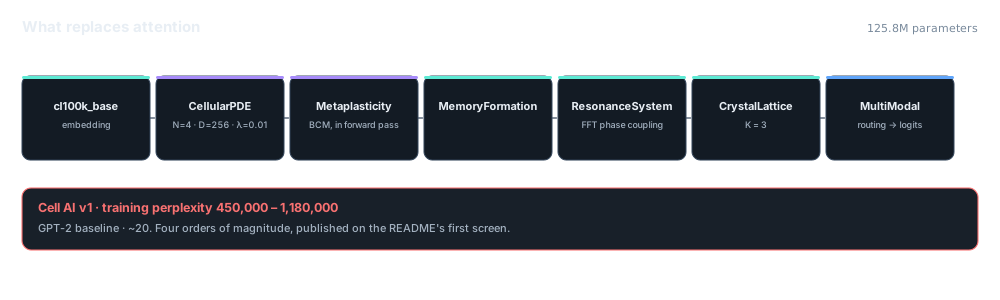
Un modelo de lenguaje construido sobre un mecanismo completamente distinto — más cerca de la química extendiéndose por una superficie que de las matemáticas de atención que usa todo lo demás. Rinde peor que un transformer, y su propia portada lo dice. No un poco peor: cuatro órdenes de magnitud en perplejidad (PPL), la medida estándar, frente al Transformador Generativo Preentrenado 2 (GPT-2) como línea base, e impreso en esta página y no en una nota al pie. Se publica como diario de investigación porque un fracaso documentado vale algo y uno borrado no.
Una perplejidad de entrenamiento de 450.000 frente a los 20 de GPT-2 no es quedarse cerca. Son cuatro órdenes de magnitud, y ninguna forma de contarlo cambia eso.
El valor está en la escalera de experimentos E0–E26 con sus fallos anotados: qué ideas arquitectónicas se vinieron abajo, cómo, y qué decían los diagnósticos. Un resultado negativo con una causa documentada es una aportación. Un resultado negativo borrado en silencio es tirar el trabajo.
Qué es esto, en un minuto
Casi toda la IA que maneja lenguaje está construida sobre la misma idea: dejar que cada palabra mire a todas las demás. Funciona. Nadie sabe cuánto de eso se debe a que es la mejor idea disponible y cuánto a que es la que probó todo el mundo.
Cell AI quita eso y pone otra cosa: dos sustancias químicas que se extienden y reaccionan por una superficie, igual que se forman las rayas de un animal, con las conexiones cambiando mientras lee y no después. Luego se entrenó a tamaño completo y se midió. Salió cuatro órdenes de magnitud peor que GPT-2. Ese es el titular de esta página, no una línea en un apéndice.
Investigadores que quieren saber qué pasa por el camino que nadie tomó. Científicos que ya modelan sistemas vivos, porque el mecanismo de debajo es el que hace los patrones en química y las marcas de los animales. Docentes, porque la investigación publicada es casi toda éxitos, y un relato cuidadoso de un fracaso es más raro y más útil.
La dinámica que hay debajo de la arquitectura
Esto es un sistema de reacción-difusión de Gray–Scott — la misma clase de dinámica sobre la que está construido el núcleo CellularPDE. Dos sustancias químicas difunden a velocidades distintas y reaccionan; las tasas de alimentación y de eliminación deciden si salen manchas, rayas, células que se dividen o nada en absoluto. La apuesta de la arquitectura es que un campo autoorganizado así puede sostener computación. Míralo y juzga tú mismo si es plausible.
CellularPDE — núcleo de reacción-difusión
Haz clic o arrastra sobre el campo para inyectar la sustancia B y perturbar el patrón.
Estado de las particiones
N = 4 particiones del campo, como en el núcleo CellularPDE. La altura es la activación media de cada partición; la fuga λ = 0,01 las acopla.
Gray–Scott con Da=1.0, Db=0.5, laplaciano de nueve puntos, Euler explícito. Este es el sustrato dinámico, no el modelo entrenado — el modelo entrenado tiene 125,8 M de parámetros y no cabe en una pestaña de navegador.
CellularPDE está construido. La arquitectura en sí es PyTorch.
Lo que sustituye a la atención
CellularPDE
N = 4 particiones de un estado de dimensión D = 256, fuga λ = 0,01, términos de reacción sigmoides — un sistema de reacción-difusión discreto puesto donde estaría la autoatención.
MetaplasticityLayer
Aprendizaje hebbiano al estilo de Bienenstock–Cooper–Munro (BCM), con α = 0,1, β = 0,01, aplicado durante el paso hacia delante y no después. Esta es la idea más atrevida de la arquitectura y el origen de su documentado problema de inanición de gradiente.
SpectralPDE y SparseHebbian
SpectralPDE reduce la complejidad de O(D²) a O(D log D). SparseHebbian comprime las actualizaciones de 65.536 pesos a 1.024. MultiScalePartitions ejecuta flujos rápidos y lentos; AnnealedRouter usa planificación con Gumbel-Softmax.
La pila completa
Incrustación cl100k_base → CellularPDE → MetaplasticityLayer → MemoryFormation → ResonanceSystem → CrystalLattice (K = 3) → acoplamiento Kuramoto opcional → enrutado de MultiModalModel → logits. La etapa de resonancia acopla fases con una transformada rápida de Fourier (FFT).
De E0 a E26, con los fallos anotados
El programa de búsqueda de arquitectura es aquí el verdadero artefacto. Veintisiete experimentos, cada uno con lo que se probó y lo que salió mal, incluidos los que fueron hacia atrás.
| Hallazgo | Resultado |
|---|---|
| PerFreqResonance | Problemas documentados, no dio resultado |
| Enrutado | Colapsó en degeneración de clases en algunas configuraciones |
| E26 vs E25 | Regresión — el experimento posterior fue peor |
| ResonanceSystem | Contribución mínima al gradiente |
| Generación (v1) | Le falta un muestreo autorregresivo en condiciones |
| v3 Cell-Fungal Harmonic | Especulativo, sin integrar |
La brecha, dicha sin rodeos
Un experimento de construir IA de una forma completamente distinta
Casi toda la IA de hoy está construida sobre la misma idea de fondo. Cell AI es un intento a escala completa con otra distinta, tomada prestada de cómo se forman los patrones en la naturaleza — publicado con sus fallos intactos.
Investigadores que miran más allá del enfoque actual
El progreso necesita que alguien pruebe el camino que no se tomó y escriba lo que pasó. Este es ese intento, a tamaño completo, con los callejones sin salida registrados en lugar de abandonados en silencio.
Científicos que modelan sistemas vivos
El mecanismo que hay debajo es el que produce las rayas de los animales y los patrones en química. Si ese es el mundo en el que trabajas, el modelo habla tu idioma.
Docentes que quieren un fracaso honesto
La investigación publicada trata de forma abrumadora sobre cosas que funcionaron. Esto es un relato cuidadoso de algo que no funcionó, lo que es mucho más útil para aprender que otra historia de éxito.
Adónde fueron estas ideas en su lugar
Cell AI es la línea de investigación que no convergió. A sus hermanos les fue mejor: Cypha se convirtió en una arquitectura funcional desde primeros principios, y el trabajo de memoria de contexto largo se convirtió en Memoria Unificada Hash-Predictiva (UHPM).