Una arquitectura de IA construida desde primeros principios, no un fork
Casi toda la inteligencia artificial (IA) moderna es una variación sobre los mismos pocos diseños. Cypha parte de otro sitio: un solo tipo de C++, con una regla de aprendizaje deducida de las matemáticas en vez de tomada prestada, que se actualiza con cada ejemplo que ve en lugar de entrenarse una vez y quedarse congelado. Es un proyecto de investigación, y los fracasos se publican junto a los resultados.
- AIXI / Solomonoff — los priores de longitud mínima de descripción (MDL) deciden qué puede creer el modelo a bajo coste.
- Geometría de la información — las actualizaciones siguen el gradiente natural, así que el aprendizaje respeta la curvatura del espacio de parámetros.
- Inferencia activa / energía libre — da la descomposición estructural en prior, diferencial y contexto.
- Cuello de botella de la información — fija el objetivo del codificador: conservar lo que predice, descartar el resto.
Qué es esto, en un minuto
Casi todos los sistemas de IA en uso son una variación sobre un puñado de diseños. Se entrenan una vez en una máquina grande y luego se envían congelados, así que seguir el ritmo de algo que se mueve — un fraude nuevo, una avería nueva — obliga a volver atrás y entrenar otra vez. También son grandes, lo que los coloca en un centro de datos y no en el equipo, y dificulta explicar cualquier decisión concreta.
Cypha es un solo tipo de C++ que clasifica, predice números y genera secuencias. Su regla de aprendizaje se deriva de cuatro cuerpos de matemáticas en vez de copiarse de una arquitectura existente, y se actualiza con cada ejemplo que ve — sin lote, sin época, sin reentrenamiento. Es lo bastante pequeño para funcionar en el propio equipo que recoge los datos.
Hoy, investigadores e ingenieros dispuestos a probar un diseño distinto. Los problemas a los que apunta son aquellos en los que los datos no paran de moverse — fraude, averías de equipos, comportamiento cambiante —, en los que el modelo tiene que estar en el dispositivo y no en un centro de datos, y en los que alguien tiene que explicar la decisión después.
Características aleatorias, medidas y no descritas
El argumento de Cypha a favor de las características de Fourier aleatorias (RFF) es que permiten a una cabeza lineal separar lo que una cabeza lineal no puede. Eso es una afirmación medible, así que aquí se mide — con cypha::rff_features compilado a WebAssembly, no una recreación en JavaScript.
cypha::rff_features — WebAssembly
sin cargarEl kernel exacto de función de base radial (RBF) sobre n puntos muestreados da una matriz K. Las características aleatorias reconstruyen una aproximación K̂. Lo que se representa es ‖K − K̂‖F a medida que crece el número de características: más características, aproximación más cercana.
chi_d para que una fila ortogonal encaje con la fila gaussiana a la que sustituye. Las filas quedaban √d veces demasiado cortas, así que las características aproximaban el kernel equivocado y el error se estancaba en lugar de converger. Una línea. Ahora es la mejor de las tres.
Siete capas, cada una con un solo trabajo
Cada componente de abajo existe porque uno de los cuatro programas lo exige — no porque apareciera en un artículo ese trimestre.
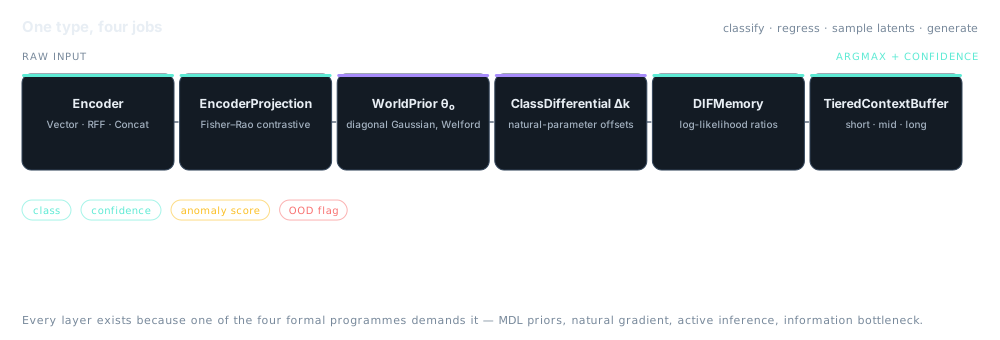
Front end intercambiable
De la entrada bruta al vector de características. Incluye VectorEncoder,
RFFEncoder (características de Fourier aleatorias) y ConcatEncoder. Cámbialo sin tocar nada aguas abajo.
EncoderProjection
Características al espacio latente mediante actualizaciones contrastivas de Fisher–Rao, con tope en la norma de Frobenius para que un solo valor atípico no pueda reventar la geometría.
WorldPrior
Una gaussiana diagonal compartida ajustada en línea con Welford y actualizaciones de media móvil exponencial (EMA). Este es el “contexto infinito” que nunca olvida — y cuyo movimiento es la señal de deriva.
ClassDifferential
Desplazamientos de parámetros naturales por clase, atraídos hacia las observaciones y devueltos por el decaimiento MDL. Una clase es un desplazamiento respecto al mundo, no un modelo aparte.
DIFMemory
Calcula razones de verosimilitud logarítmica bajo posteriores hiperbólicas generalizadas, con tablas de búsqueda de razones de Bessel para que las colas pesadas no cuesten una trascendente por muestra.
TieredContextBuffer
Niveles corto, medio y largo ponderados por la confianza de NIGField, para que la evidencia reciente pueda dominar sin borrar lo que estableció el nivel largo.
Entrena un clasificador haciendo clic
Una miniatura fiel en 2-D de la cadena de Cypha: un prior del mundo ajustado en línea, diferenciales por clase atraídos hacia lo que colocas, y clasificación por razón de verosimilitud logarítmica. Aprende de cada clic — no hay lote, ni época, ni reinicio.
cypha::Cypha — clasificador en línea
Haz clic en el lienzo para añadir una muestra de la clase seleccionada. Arrastra para pintar un grupo.
Clase a colocar
Carga un conjunto de datos
Última inferencia
Diferenciales de clase Δₖ
Resultados, con la comparación que importa
Cifras de las propias ejecuciones de benchmark del repositorio, después del arreglo del diagnóstico. La corrección se demuestra con una matriz de CTest que coincide con los goldens de fixtures versionados — no con un puesto en una tabla de clasificación.
Abreviaturas de la tabla: descenso de gradiente estocástico (SGD), memoria larga de corto plazo (LSTM), retropropagación a través del tiempo (BPTT).
| Conjunto de datos | Tarea | Cypha | SGD en línea | Nota |
|---|---|---|---|---|
| Linealmente separable | 2 clases | 0.783 | 0.644 | Mismo presupuesto en línea |
| Iris | 3 clases | 0.900 | — | Conjunto de referencia clásico |
| Wine | 3 clases | 0.969 | — | |
| Digits | 10 clases | 0.922 | — | |
| Breast cancer | 2 clases | 0.957 | — | |
| WikiText-2 | Secuencia, 300k tokens | 2,664 BPC | — | Híbrido GRIA+LSTM L2+Wave2 BPTT |
| XOR | 2 clases, RFF latente | ~0.763 | — | El LLR lineal por sí solo se topa cerca del azar |
Escalado por temperatura, condicionado por campo, interpolación de frontera latente, adversarial (maximizando la entropía), muestreo OOD, restringido por MDL, ancestral y muestreo KDE desde el búfer de repetición.
Puntuaciones de anomalía a partir de los valores de las puertas, puntuaciones de consulta activa como entropía × proximidad a la frontera, y detección de deriva leída directamente del movimiento del prior del mundo.
Un búfer de prioridad con capacidad para 10.000, ponderado por recencia y sorpresa, reproducido con una proporción de 0,30 — para que la muestra rara e informativa no quede ahogada por la común.
Perfilados, no adivinados
Salen de una optimización perfilada sobre malla media y se distribuyen como la configuración de referencia.
Lo que Cypha no es
- No es un envoltorio. Hecho a medida desde primeros principios — lo que también significa que no hereda el ajuste de nadie más.
- El LLR lineal tiene un techo. XOR se queda cerca del azar sin el codificador RFF latente, que lo sube hasta aproximadamente el 76,3%.
- La validación es por paridad. CTest contra goldens de fixtures versionados. No se hace ninguna afirmación sobre tablas de clasificación.
- CUDA es solo para inferencia. El entrenamiento se queda en la unidad central de proceso (CPU), porque en esta arquitectura la CPU es más rápida.
- La teoría está en otro sitio. El trabajo sobre espectro armónico y NMP es un artículo aparte sobre algoritmos de compresión; Cypha es la capa de implementación.
Cypha, destilado de un motor de ajedrez real
26.568 posiciones etiquetadas con las evaluaciones de búsqueda de un motor alfa-beta convencional, ajustadas con el mismo blanqueo de WorldPrior y las mismas actualizaciones de gradiente natural que se usan en todo el resto de la arquitectura. Reproduce la evaluación del maestro con un R² 0,866 en posiciones reservadas, y anota 5 victorias–19 derrotas–6 tablas contra ese maestro a igual profundidad de búsqueda.
Una IA pequeña que sigue aprendiendo
Casi toda la IA se entrena una vez en un centro de datos y se distribuye congelada. Cypha es lo bastante pequeña para funcionar en hardware corriente y sigue aprendiendo de cada ejemplo nuevo que ve.
Dispositivos demasiado pequeños para la IA grande
Sensores, cámaras, controladores y otro hardware que no tiene sitio para un centro de datos detrás. Cypha es lo bastante pequeña para funcionar en el propio dispositivo, así que no hace falta que nada salga del edificio.
Cualquier cosa que tenga que seguirle el ritmo al cambio
Patrones de fraude, averías de equipos, comportamiento cambiante de los clientes. Un modelo entrenado el año pasado ya está desfasado. Este se actualiza sobre la marcha, sin retirarlo y reentrenarlo.
Trabajo que después hay que explicar
Bancos, aseguradoras y servicios de salud tienen a menudo que justificar una decisión. Cypha es lo bastante pequeña para inspeccionarla, y publica en qué es mala en vez de esconderlo.
Tres comandos
$ cmake -S native -B /tmp/cypha_build -DCMAKE_BUILD_TYPE=Release -G Ninja
$ cmake --build /tmp/cypha_build --parallel
$ ctest --test-dir /tmp/cypha_build -R native_ --output-on-failure

# REST service
$ cypha_rest --listen 127.0.0.1:8099 --cypha fixtures/reference.cypha
# Qt shell (build with -DCYPHA_BUILD_QT=ON)
$ cypha_qt_shell