一套从 第一性原理出发构建的 AI 架构,不是 fork 来的
几乎所有现代人工智能(AI)都是同样那几种设计的变体。Cypha 的起点在别处:一个 C++ 类型,学习规则是从数学里推出来的,不是借来的,而且它每见到一个样本就更新一次,而不是训练一次就冻住。这是一个研究项目,失败的部分和结果一起发布。
- AIXI / Solomonoff — 最小描述长度(MDL)先验决定模型可以廉价地相信哪些东西。
- 信息几何 — 更新沿着自然梯度走,所以学习尊重参数空间的曲率。
- 主动推断 / 自由能 — 给出先验、差分与上下文这套结构分解。
- 信息瓶颈 — 定下编码器的目标:留下能预测的,其余丢掉。
一分钟说清这是什么
在用的 AI 系统几乎全是少数几种设计的变体。它们在大机器上训练一次,然后冻住发出去,所以要跟上会变的东西 — 一种新的欺诈手法、一种新的故障 — 就得回去重新训练。它们还很大,于是只能待在数据中心里而不是设备上,也让解释任何一次单独的决定变得很难。
Cypha 是一个 C++ 类型,能分类、预测数值、生成序列。它的学习规则是从四套数学里推导出来的,不是从现成架构抄来的,而且它每见到一个样本就更新一次 — 没有批次,没有轮次,也没有重训这一步。它小到可以在采集数据的那台硬件上跑。
眼下是愿意试一种不同设计的研究者和工程师。它瞄准的问题,是数据一直在动的那些 — 欺诈、设备故障、变化中的行为 — 是模型必须待在设备上而不是数据中心里的那些,也是事后得有人把决定解释清楚的那些。
随机特征,测出来的,不是说出来的
Cypha 为随机傅里叶特征(RFF)给出的理由是:它们能让一个线性头分开线性头本来分不开的东西。这是一个可以测量的主张,所以这里就把它测出来 — 用的是 cypha::rff_features 编译成的 WebAssembly,不是用 JavaScript 复述一遍。
cypha::rff_features — WebAssembly
未加载径向基函数(RBF):在 n 个采样点上的精确 RBF 核给出一个矩阵 K。随机特征重建出一个近似 K̂。画出来的是 ‖K − K̂‖F 随特征数增长的变化:特征越多,近似越接近。
chi_d 里抽取行范数的,好让一个正交行与它替换掉的那个高斯行对得上。行短了 √d 倍,于是特征近似的是错的核,误差不收敛,而是走平了。一行代码。现在它是三者里最好的。
七层,每一层只做一件事
下面每一个组件之所以存在,都是因为那四条纲领里有一条要求它 — 而不是因为它那个季度出现在某篇论文里。
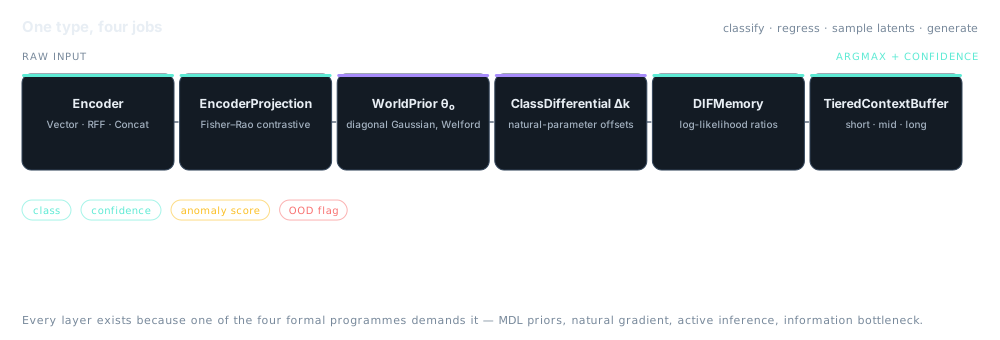
可插拔的前端
从原始输入到特征向量。自带 VectorEncoder,
RFFEncoder (随机傅里叶特征)与 ConcatEncoder。换掉它不用动下游的任何东西。
EncoderProjection
通过 Fisher–Rao 对比更新把特征送进隐空间,并给 Frobenius 范数设上限,这样单个离群点没法把几何结构炸开。
WorldPrior
一个共享的对角高斯分布,由 Welford 与指数滑动平均(EMA)更新在线拟合。这就是那个从不遗忘的“无限上下文” — 而它的移动就是漂移信号。
ClassDifferential
每个类一组自然参数偏移,被观测拉过去,又被 MDL 衰减拽回来。一个类是 相对于世界的位移,不是一个单独的模型。
DIFMemory
在广义双曲后验下计算对数似然比,配上贝塞尔比值查找表,这样重尾不会让每个样本都付出一次超越函数的代价。
TieredContextBuffer
短、中、长三层按 NIGField 的置信度加权,这样近期的证据可以占主导,又不会抹掉长期那层已经确立的东西。
点几下训练一个分类器
Cypha 流水线忠实的二维缩微版:在线拟合的世界先验、被你放下的点吸引过去的各类差分,以及按对数似然比做的分类。它从你的每一次点击里学习 — 没有批次,没有轮次,也不重启。
cypha::Cypha — 在线分类器
点击画布,加入一个所选类别的样本。拖动可以刷出一团。
要放置的类别
载入一个数据集
上次推理
类差分 Δₖ
结果,以及真正要紧的那组对比
数字来自仓库自己在诊断修复之后跑的基准测试。正确性由一套 CTest 矩阵对上已提交的夹具基准值来证明 — 不是靠排行榜上的名次。
表里的缩写:随机梯度下降(SGD)、长短期记忆(LSTM)、随时间反向传播(BPTT)。
| 数据集 | 任务 | Cypha | 在线 SGD | 备注 |
|---|---|---|---|---|
| 线性可分 | 2 类 | 0.783 | 0.644 | 同样的在线预算 |
| Iris | 3 类 | 0.900 | — | 经典基准数据集 |
| Wine | 3 类 | 0.969 | — | |
| Digits | 10 类 | 0.922 | — | |
| Breast cancer | 2 类 | 0.957 | — | |
| WikiText-2 | 序列,30 万 token | 2.664 BPC | — | 混合 GRIA+LSTM L2+Wave2 BPTT |
| XOR | 2 类,隐空间 RFF | ~0.763 | — | 只用线性 LLR 时上限接近瞎猜 |
温度缩放、场条件、隐空间边界插值、对抗式(最大化熵)、OOD 采样、MDL 约束、祖先采样,以及从回放缓冲区做 KDE 采样。
异常分数来自门控值,主动查询分数是熵 × 到边界的接近程度,漂移检测直接从世界先验的移动上读出来。
一个容量 10,000 的优先级缓冲区,按新近程度和意外程度加权,以 0.30 的比例回放 — 这样稀有而有信息量的样本不会被常见的那些淹掉。
跑过性能剖析的,不是猜的
这些是从一次带性能剖析的中等网格优化里得出来的,作为参考配置发布。
Cypha 不是什么
- 不是包装层。 从第一性原理定制而来 — 这也意味着它继承不到别人调好的参数。
- 线性 LLR 有天花板。 没有隐空间 RFF 编码器时,XOR 停在接近瞎猜的水平,加上它之后大约提到 76.3%。
- 验证是基于一致性的。 用 CTest 对已提交的夹具基准值。不做任何排行榜上的声称。
- CUDA 只用于推理。 训练留在中央处理器(CPU)上,因为在这套架构上 CPU 更快。
- 理论在别处。 谐波谱和 NMP 的工作是另一篇讲压缩算法的论文;Cypha 是实现层。
一个会一直学下去的小型 AI
大多数 AI 在数据中心里训练一次,然后冻住发出去。Cypha 小到可以在普通硬件上跑,而且会从它见到的每一个新样本继续学。
小到装不下大 AI 的设备
传感器、摄像头、控制器,以及其他后面塞不下一个数据中心的硬件。Cypha 小到可以直接在设备上跑,所以没有任何东西必须离开这栋楼。
任何必须跟上变化的场合
欺诈模式、设备故障、变动中的客户行为。去年训练的模型现在已经过时了。这一个边跑边更新,不用下线重训。
事后必须解释清楚的工作
银行、保险公司和医疗机构常常得为一个决定给出理由。Cypha 小到可以逐一检查,而且它把自己不擅长的地方公布出来,而不是藏起来。
三条命令
$ cmake -S native -B /tmp/cypha_build -DCMAKE_BUILD_TYPE=Release -G Ninja
$ cmake --build /tmp/cypha_build --parallel
$ ctest --test-dir /tmp/cypha_build -R native_ --output-on-failure

# REST service
$ cypha_rest --listen 127.0.0.1:8099 --cypha fixtures/reference.cypha
# Qt shell (build with -DCYPHA_BUILD_QT=ON)
$ cypha_qt_shell