Cypha / 国际象棋
来下一盘国际象棋,对手是 Cypha
Cypha 从来没看过一盘棋。它是看着一个普通的国际象棋程序思考学会的 — 26,568 个局面,每一个都标上了那个程序自己对谁占优的判断 — 直到 Cypha 能自己给出这个判断。
你在下面对弈的就是它,在你的浏览器里跑,外面套一层浅搜索。它是能被赢的,而且它到今天还是下不过当初教它的那个程序。本页上的每一个数字,都出自产生这个页面所加载权重的那次训练。
下面的均方根误差(RMSE)是衡量一组猜测偏了多远的常用指标;它越小,模型离它的老师就越近。
R² 是在模型拟合时从没见过的留出局面上算的。对局那一行是 Cypha 在搜索深度 2 对同样深度的教师引擎,开局随机,执先执后轮换。这四个数字描述的都是 蒸馏出来时的那个模型 — 它们是固定的,不是对你这一份副本的测量。
这是预期中的结果,值得说出来而不是藏起来。信号来自模型自己的深度 2 搜索,而这比静态头自己的视野也深不了多少 — 学会跟自己保持一致,和变强不是一回事。相比它蒸馏时用的 26,568 个局面,一千个局面也什么都不算。老实的说法是:在线学习器能用,也确实在做它说的事;至于它会赢过发布版模型这个说法,还没有挣到。
一分钟说清这是什么
每一种新的人工智能(AI)设计出场时,都带着一套它为什么应该管用的说法。读那套说法,说明不了它到底管不管用。国际象棋能了结这件事,因为答案不是看法问题:它要么下出合规而合理的棋,要么下不出,而你可以坐下来自己查验。
一个普通的国际象棋程序靠往前搜索走法来判断局面。Cypha 被喂了 26,568 个这样的判断,然后拟合出一个公式来复现它们 — 一行数学,作用在描述棋盘的 388 个数字上。为了国际象棋,架构里什么都没加。变的只是喂进去的数字。
任何在掂量 Cypha、宁愿自己查验也不愿听人说的人。做机器学习的人,想亲眼看看一个模型在被使用的同时继续学习。还有任何单纯想下一盘的人 — 全部在你的浏览器里跑,你下的棋不会被发送到任何地方。
cypha::Cypha — 国际象棋头 学习中
点一个棋子,再点它要去的格子。合法的落点会标出来。
局面
Cypha 考虑过的走法
走法
从你身上学到的
漂移 是权重向量相对于蒸馏版的改动幅度。 上一次修正 是静态头对它刚刚走出的那个局面判断错了多少,以兵为单位,对着它自己更深的搜索来衡量。
等级分 是一套内部天梯上的分数,不是国际象棋联合会(FIDE)的分级 — 对一个从没和有等级分的人类下过棋的东西,没有任何老实的办法给它安一个 FIDE 数字。参考引擎在深度 1 上锚定为 1000,其余全部由 210 盘棋按 Bradley-Terry 极大似然拟合出来,所以不依赖对局的先后顺序。实测天梯:参考引擎在深度 1–3 上是 1000 / 1171 / 1245,Cypha 是 798 / 1010 / 1161。Cypha 大约比蒸馏出它的那个引擎落后一个搜索深度,误差棒大致是 ±50,这就是 210 盘棋能买到的精度。
每一档棋力设置都保留 它自己的模型。在深度 1 下棋的头,修正目标是深度 1 的搜索;到了深度 3,目标就是另一个更好的搜索。把两者训练进同一个权重向量,只会让它们互相打架。切换棋力,计数器也跟着换。
一个引擎是怎么变成一个 Cypha 模型的
这就是知识蒸馏,用的组件和 Cypha 的其他每一个应用完全一样。架构里没有加任何专门为国际象棋准备的东西 — 只加了特征。
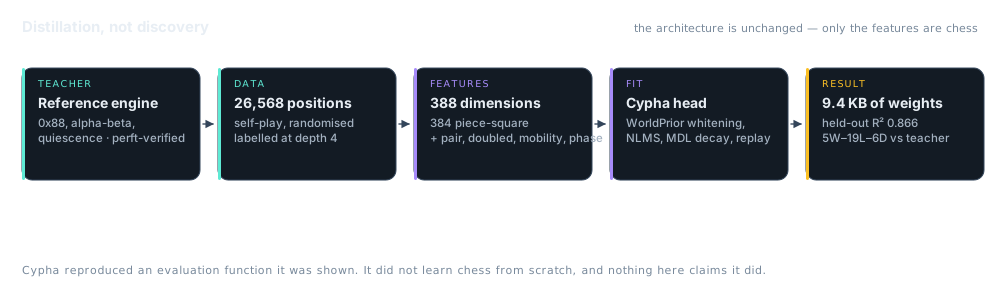
教师
一个 0x88 引擎,带完整的合法走法生成、子力与棋子位置评估、最有价值受害者 – 最无价值攻击者(MVV-LVA)排序,以及静止搜索。它对照包括 kiwipete 在内的五个标准 perft 局面验证过,所以在从它学到任何东西之前,规则就是可证明正确的。
数据
局面取自自我对弈,开局随机,还刻意加了噪声,这样这个集合覆盖的是真实棋局,而不是一条狭窄的变例。每个局面都用教师自己的搜索分数标注,并截断到 ±12 个兵,免得将杀分数占了主导。
特征
388 维:一个 384 宽的子力-格位占据差(6 种棋子 × 64 格),再加上双象、叠兵、机动性和棋局阶段。一律从轮到走棋一方的视角出发,所以一个权重向量黑白通用。
拟合
WorldPrior θ₀ 由 Welford 在线拟合,白化充当自然梯度的度量,归一化最小均方(LMS)权重更新,最小描述长度(MDL)衰减把权重拽回先验,还有一个按意外程度加权、比例为 Cypha 参考值 0.30 的回放缓冲区。
干活的是架构,不是这个领域
第 4 步里的每一个组件都是真正的 Cypha 组件,干的也是它真正的活。这个 WorldPrior 就是那个在线高斯分布, Cypha 页面 上的二维分类器的决策面就是它给的。白化是把信息几何那条主张落到实处:更新沿着自然梯度走,而不是原始梯度。MDL 衰减则是把 Solomonoff 先验表达成一个收缩项。
为国际象棋改的是特征映射和头 — 用回归代替分类。这正是 Cypha README 关于一个类型做好几件工作的那个论点,放在一个答案毫不含糊的领域里检验:它要么下的是合法、说得过去的棋,要么不是。
老实说出来的局限
- 它是线性的。 一个作用在棋子位置特征上的线性函数,表示不了王的安全、兵形之间的相互作用,也表示不了任何需要两个特征相乘的东西。它的天花板,和 Cypha README 里描述的异或(XOR)那个天花板是同一个。
- 教师本身水平一般。 参考引擎是一个称职的经典搜索器,不是 Stockfish。把它蒸馏好,意思就是把一个水平一般的评估器复现得好。
- 它自己没有搜索深度。 这里的棋力大部分来自外面那层 alpha-beta 包装,教师那边也完全一样。
- 蒸馏不是发现。 Cypha 复现的是一个给它看过的评估函数。它不是从零学会下棋的,本页上也没有任何地方声称它是。
node tools/chess/perft.js 对着标准测试局面校验这个引擎,而 node tools/chess/train.js 用一个固定的随机种子从头重新生成模型。本页顶部那些数字是直接从那次运行产生的文件里读出来的。