一个还原 算法的反编译器,不只是还原代码
机构常常需要弄懂自己没有源码的软件:一套老系统、一个买来的组件、一个来路不明又看着可疑的东西。把机器码还原成可读步骤的工具已经有了。RetDec Imortek 想再往前走一步,给这些步骤起个名字 — 这一段是高级加密标准(AES),这一段是排序,这一段是数据发送前的打包方式。
上游的 RetDec v5.0 从 2022 年起就没动静了。它仍然是少数几个前端覆盖面真正广的开源反编译器之一 — 而这个覆盖面值得留着。
一分钟说清这是什么
软件交付出去的形态,是机器读得懂、人读不懂的东西。一旦没有源码 — 供应商没了、合同里本来就没写、文件来自你不信任的地方 — 就没人说得清这个程序到底在干什么。靠手工去查,就是一条一条读机器指令。
它把编译好的文件拆开,再从里面重建出 C:测试语料里全部 216 个二进制文件都能还原成可构建的 C。然后它去追意义 — 哪种密码学、哪种排序、哪种线程、哪种文件格式 — 并报告这件事成功的频率,包括它几乎不成功的那种情况。
拆恶意软件的安全团队,他们先要答案,再要代码。在跑没人有源码的软件的公司,在安全地重建或替换任何东西之前,先得有一份对它的描述。以及任何被一种从来没有文档的文件格式卡住的人 — 旧档案,或者一台只肯跟自家软件说话的机器。
真正的解码器,编译成了 WebAssembly
这上面的一切都是沿着抽象阶梯走的脚本化演示。这一级是真的在跑:Capstone — 和本地 RetDec 构建所链接的是同一个反汇编器 — 解码你粘贴进来的字节。
capstone — WebAssembly
791 千字节(KB),因为一个真正的 x86 解码器带着整套指令集 — 每一种编码、前缀和扩展。这就是这东西老实的大小。
deps/capstone.
原生、字节码和新兴格式
输出取决于格式,因为假装什么东西都能反编译成 C 帮不了任何人。前端接受可执行与可链接格式(ELF)、可移植可执行文件(PE)和 Mach-O 的原生二进制;字节码,包括 Java 虚拟机(JVM)class 文件、Dalvik 可执行文件(DEX)和公共中间语言(CIL);以及 CUDA 的并行线程执行(PTX)这类较新的目标。
ELF · PE · Mach-O
产出 C 伪代码,外加这个 fork 真正要的那一层语义。
Python · Lua · JVM · DEX · CIL
Python 和 Lua 字节码返回的是它们自己的语言;托管代码路径产出的是 Java 系或 C# 系的输出。
WebAssembly · CUDA PTX
WebAssembly 转成 WebAssembly 文本格式(WAT)。PTX 是当作一等输入来处理的,不是事后补的。
看一个函数爬上抽象阶梯
挑一个二进制函数,让它一步步走过流水线:原始字节、反汇编、抬升后的 IR、C 伪代码,最后是语义判定 — 那个有名字的算法,以及识别出它的证据。
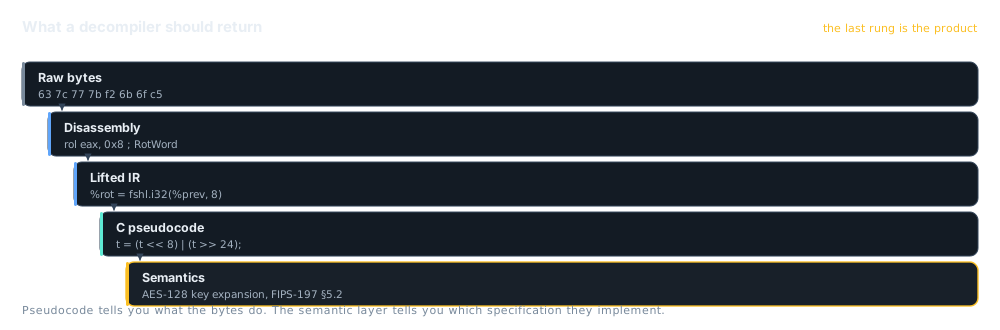
retdec — 规格提取
语义判定
证据
符号被剥掉之后,还原只能靠结构本身 — 常量、轮数、控制流形状。那是难的那种情况,也是实测 F1 0.056 所指的那一种。
六类结构
标准模板库(STL)容器和 C++ 运行时结构 — 一个 std::vector 的形状从分配模式里重新浮现出来。
AES、安全散列算法(SHA)家族、ChaCha20、Rivest–Shamir–Adleman(RSA)以及椭圆曲线原语,靠常量和轮结构辨认出来。
内省排序、归并排序、二分查找 — 包括那个会暴露内省排序身份的深度限制切换。
图算法,外加广度优先搜索(BFS)和深度优先搜索(DFS)的遍历模式。
std::thread、pthreads、OpenMP、线程构建模块(TBB)和裸原子操作。
Protobuf、FlatBuffers、MessagePack、JavaScript 对象表示法(JSON)和可扩展标记语言(XML)的封帧。
216 个二进制文件,以及那个难看的数字
测试语料里全部 216 个 ELF 二进制文件,加上
--buildable之后都能产出可构建的 C 代码,而这个选项默认就是开的。算法还原是另一回事,老实的报告方式是把两个数字并排放出来。
| 指标 | 结果 | 条件 |
|---|---|---|
| 可构建的 C 输出 | 216 / 216 | --buildable,默认开启 |
| 算法还原 F1 | 0.056 | 不借助符号名,95% 置信区间 0.034–0.083 |
| 算法还原 F1 | 1.000 | 借助符号名,带符号的二进制文件 |
默认的 .c 能重新编译 | 否 | 这个 fork 和原版 RetDec 都不行 |
可选、离线,而且要过关卡
精修通过 llama.cpp 用 GGUF 模型来跑,完全离线,而且只在设置了
RETDEC_NEURAL_REFINE=1 并给出模型路径时才跑。它默认关闭,也从不取代基线输出。
- 编译关卡。 精修后的输出必须先通过
gcc -fsyntax-only才会被接受。 - 结构校验。 精修结果必须仍然对应抬升出来的结构。
- 确定性基线保留。 没精修过的反编译器输出仍然是那份可审计的产物。如果你要为一个结论辩护,你辩护的是那一份。
- 不联网。 本地 GGUF 推理。关于你那个二进制文件的任何信息都不会离开这台机器。
$ export RETDEC_NEURAL_REFINE=1
$ export RETDEC_NEURAL_MODEL=/models/qwen-coder.gguf
$ retdec-decompiler --buildable ./target.elf
在源码已经不在的时候,弄清楚一个程序在做什么
软件发出来的样子,是机器读得懂、人读不懂的。这个工具把它重新拆开,用大白话告诉你这个程序实际上在做什么。
拆解恶意软件的安全团队
你拿到的不是一页页读不懂的代码,而是答案:这一段在打乱数据,这一段是它怎么回连控制端的,这一段是它怎么藏起来的。这才是分析人员最先需要的那一块。
有老软件但没有源码的公司
系统还在撑着业务,而当初写它的人几年前就走了。这个工具还原出一份关于它做什么的描述,而在任何人能安全地重建或替换它之前,你需要的正是这个。
任何被一个没人写过文档的文件格式卡住的人
老档案、一台只跟自家软件说话的机器、竞争对手导出的文件。这个工具把结构弄清楚,好让你自己的软件能读。