侦查线索,每一条都能 追溯回源头
调查人员很少缺数据。难的是在成千上万条单看都平平无奇的记录里找出模式。SENTINEL 是一个桌面工具,读入公开的犯罪数据,对它跑统计,再把值得细看的东西排序 — 而每一个结果都能回溯到它来自的那些具体记录、模型和设置。如果一名分析员说不出一条线索为什么排在那个位置,它就不该算一条线索。
这是一个分析软件,从公开的犯罪数据里给地点和关联排序。它是用来引导分析人员注意力的工具,不是一个对某个人做出任何决定的系统。
校准页和公平性页之所以存在,是因为一个排序不错但校准很差的模型,比没有模型更危险。第 3–5 阶段的规划明确以公平性优先,而公开发布基准结果是写明的交付物,不是一句营销话术。
一分钟说清这是什么
一起入室盗窃、一起车内失窃、一份保险理赔。单看每一件都平平无奇,把它们连起来的东西,只有当有人把几百件排开来看的时候才显出来。手工做很慢,而能成规模做这件事的分析合同,价钱高到大多数警队够不着。
SENTINEL 把记录读进来,对它们跑成熟的统计模型:犯罪在哪里密集、哪些案件看着像同一串而不是好几串、一串案件最可能是从哪个区域作出来的。它把值得细看的东西排序。每一个阶段都写下自己做了什么,所以一条线索送到时,源记录、背后的模型和设置都跟着来。
够不着大额分析合同的中小型和地方警队 — 这东西在一台普通台式机上就能跑,而且是给单个分析员用的,不是给一个部门用的。查欺诈和惯犯的调查员,那里的模式横跨着一堆没人归到一起的案件。还有研究者,他们可以把任何结果回溯到产生它的那些记录。
两个真正的模型,编译成了 WebAssembly
models/KDEHotspot 与 models/HawkesProcess — 和分析人员在桌面上跑的是同一份 C++,用 Qt for WebAssembly 编译,喂给它的是你自己放下的点。点地图就能添加案件。
KDEHotspot + HawkesProcess — WebAssembly
未加载2.4 兆字节(MB),因为 Qt6Core 跟着一起来了。这就是跑真模型而不是一个仿制品的老实代价,而且你不开口,什么都不会下载。
摄入 → 自然语言处理(NLP) → 特征 → 模型 → 推理
每一个阶段都把自己做了什么写进来源链,所以末端的一条线索,带着它一路是怎么来的记录。
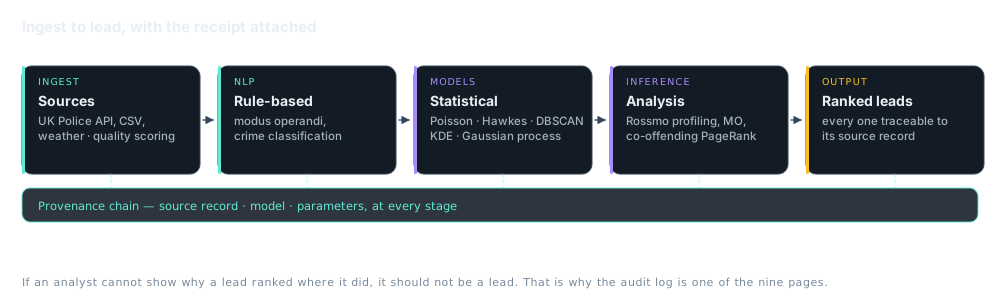
英国警方应用程序接口(API)与历史数据源,逗号分隔值(CSV)导入并自动识别英国 / 美国城市 / 通用三种版式,天气通过 Open-Meteo 获取,以及带隔离阈值的数据质量评分。
经典的、基于规则的作案手法提取与犯罪分类。回路里没有语言模型 — 这是故意的,因为输出必须解释得清楚。
泊松计数、霍克斯自激过程、用具有噪声的基于密度的空间聚类(DBSCAN)做串案检测、KDE 热点、高斯过程回归,以及贝叶斯与集成层。
Rossmo 地理画像、作案手法分析、证据评分、异常检测、共同作案的 PageRank 与社区发现,还有提示引擎。
同一批案件上的两个模型
在地图上放下案件。 KDE 问的是犯罪在哪里密集。 Rossmo 公式 问的是另一个更有意思的问题:既然作案者会避开自己家周围的一圈缓冲区,那作案者最可能住在哪里?两个都是实时跑的,用的是你放下的同一批点。
sentinel — 空间推理
点一下加一起案件。每加一个点,这些曲面都会重算。
排名第一的线索
来源链
今天能用的东西
- 从摄入到排好序线索的端到端流水线
- 495 个自动化测试
- 在英国和美国数据集上做的真实数据验证
- Windows 与 Linux 打包
- 本地只读的表述性状态转移(REST)API
- 九页仪表盘:事件、地图、校准、案件、共同作案图、线索、审计日志、设置、调试
不能用的东西
- 只有基于规则的 NLP。 作案手法提取是经典方法,也就带着这意味着的召回率上限。
- 单机桌面。 没有多用户部署,分析人员之间也没有共享的案件状态。
- 实时连接器有限。 接上的实时数据源不多。
- 地图很基础。 自己渲染的,不是地理信息系统(GIS)。可选的 GIS 集成是第 3–5 阶段的事项。
第 3–5 阶段,计划中
多辖区支持、可选的 GIS 集成、公开发布的基准结果、公平性优先的部署,以及一项可能的托管服务。待办清单在
REMAINING.md 里,不在一份路线图幻灯片里。
在犯罪数据里找出规律,并把过程摊开给你看
分析人员被案件记录淹没。这个工具在这些记录之间找规律,把值得细看的排出先后,同时为每一条建议留下一条通回证据的线索。
规模较小的和地方性的警队
大型分析合同对大多数预算来说都够不着。这个在一台普通台式机上就能跑,面向的是一个分析人员,而不是一个部门。
查欺诈和惯犯的调查人员
保险欺诈和有组织的零售盗窃,在有人把它们排到一起之前,看起来就是一堆互不相干的案件。这个工具负责排,并且指出下一起大概会在哪里。
研究犯罪与警务的研究者
每一个结果都能追回到产生它的那些具体记录和设置,所以另一个研究者可以去核查这份工作,而不是凭信任接受。