Des pistes d’enquête que l’on peut remonter à la source
Les enquêteurs manquent rarement de données. Ce qui est difficile, c’est de trouver le motif au milieu de milliers d’enregistrements qui, pris un par un, n’ont rien de remarquable. SENTINEL est un outil de bureau qui lit les données publiques sur la criminalité, y applique les statistiques et classe ce qui mérite un examen plus attentif — et chaque résultat remonte aux enregistrements, au modèle et aux réglages exacts dont il vient. Si un analyste ne peut pas montrer pourquoi une piste est classée là où elle est, ce ne devrait pas être une piste.
Ceci est un logiciel d’analyse qui classe des lieux et des associations à partir de données publiques sur la criminalité. C’est un outil pour orienter l’attention d’un analyste, pas un système qui décide quoi que ce soit au sujet d’une personne.
Les pages de calibration et d’équité existent parce qu’un modèle bien classé et mal calibré est plus dangereux que pas de modèle du tout. La planification des phases 3–5 place explicitement l’équité en premier, et des mesures publiées sont un livrable annoncé, pas une affirmation marketing.
Ce que c’est, en une minute
Un cambriolage, un vol dans une voiture, une déclaration de sinistre. Chacun n’a rien de remarquable en soi, et ce qui les relie n’apparaît que lorsque quelqu’un en aligne des centaines et regarde. C’est un travail lent à la main, et les contrats d’analyse qui le font à grande échelle sont hors de prix pour la plupart des polices.
SENTINEL lit les enregistrements et leur applique des modèles statistiques établis : où la criminalité est dense, quels faits ressemblent à une seule série plutôt qu’à plusieurs, depuis quelle zone une série a le plus probablement été menée. Il classe ce qui mérite un examen plus attentif. Chaque étape écrit ce qu’elle a fait, si bien qu’une piste arrive en portant ses enregistrements d’origine, le modèle et les réglages qui la sous-tendent.
Les polices régionales et de petite taille, pour qui les gros contrats d’analyse sont hors d’atteinte — ceci tourne sur un ordinateur de bureau ordinaire et est conçu pour un analyste seul plutôt que pour un service. Les enquêteurs sur la fraude et la récidive, où le motif s’étale sur des faits que personne n’a classés ensemble. Les chercheurs, qui peuvent retracer n’importe quel résultat jusqu’aux enregistrements qui l’ont produit.
Deux des vrais modèles, compilés en WebAssembly
models/KDEHotspot et models/HawkesProcess — le même C++ qu’un analyste exécute sur son poste, compilé avec Qt pour WebAssembly et alimenté par des points que vous placez vous-même. Cliquez sur la carte pour ajouter des incidents.
KDEHotspot + HawkesProcess — WebAssembly
non chargée2,4 mégaoctets (Mo) parce que Qt6Core vient avec. C’est le coût honnête de faire tourner le vrai modèle plutôt qu’un sosie, et rien ne se télécharge tant que vous ne le demandez pas.
Ingestion → traitement du langage naturel (NLP) → caractéristiques → modèles → inférence
Chaque étape écrit ce qu’elle a fait dans la chaîne de traçabilité, si bien qu’une piste, au bout, porte le relevé de la façon dont elle est arrivée là.
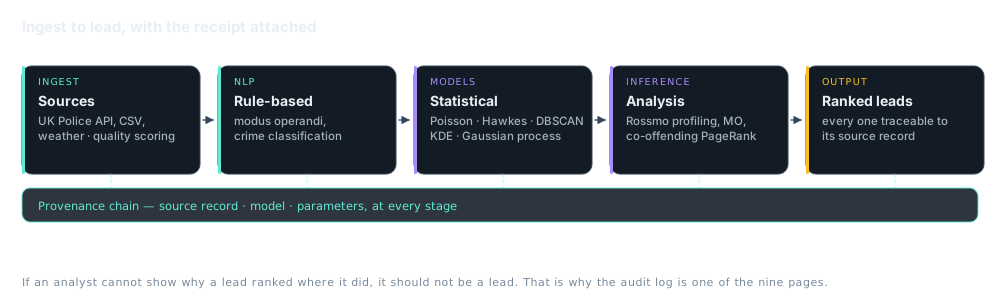
Interface de programmation applicative (API) de la police britannique et flux historiques, import de valeurs séparées par des virgules (CSV) à disposition auto-détectée (Royaume-Uni / ville américaine / générique), météo via Open-Meteo, et notation de la qualité des données avec seuils de quarantaine.
Extraction du mode opératoire et classification des délits, classiques, à base de règles. Aucun modèle de langage dans la boucle — délibérément, parce que la sortie doit être explicable.
Comptages de Poisson, processus auto-excitants de Hawkes, détection de séries par partitionnement spatial basé sur la densité d’applications avec bruit (DBSCAN), points chauds par KDE, régression par processus gaussien, couches bayésiennes et d’ensemble.
Profilage géographique de Rossmo, analyse du mode opératoire, notation des preuves, détection d’anomalies, PageRank de co-délinquance et détection de communautés, et le moteur d’indices.
Deux modèles sur les mêmes incidents
Placez des incidents sur la carte. KDE demande où la criminalité est dense. La formule de Rossmo pose une question différente et plus intéressante : étant donné que les délinquants évitent une zone tampon autour de chez eux, où le délinquant habite-t-il le plus probablement ? Les deux tournent en direct, sur les mêmes points que vous placez.
sentinel — inférence spatiale
Cliquez pour ajouter un incident. Les surfaces se recalculent à chaque point.
Piste la mieux classée
Chaîne de traçabilité
Ce qui marche aujourd’hui
- Pipeline de bout en bout, de l’ingestion aux pistes classées
- 495 tests automatisés
- Validation sur données réelles, jeux britanniques et américains
- Paquets Windows et Linux
- API locale de transfert d’état représentationnel (REST), en lecture seule
- Tableau de bord de neuf pages : événements, carte, calibration, affaires, graphe de co-délinquance, pistes, journal d’audit, réglages, débogage
Ce qui ne marche pas
- NLP à base de règles uniquement. L’extraction du mode opératoire est classique, avec les limites de rappel que cela implique.
- Poste unique. Pas de déploiement multi-utilisateur, pas d’état d’affaire partagé entre analystes.
- Connecteurs en direct limités. Peu de sources de données en temps réel sont câblées.
- Carte sommaire. Rendu sur mesure, pas un système d’information géographique (SIG). L’intégration SIG en option est un point des phases 3–5.
Phases 3–5, prévues
Prise en charge multi-juridiction, intégration SIG en option, mesures publiées, déploiement avec l’équité en premier, et un service géré possible. Le carnet de tâches est dans
REMAINING.md plutôt que dans une présentation de feuille de route.
Trouve des motifs dans les données criminelles, et montre son raisonnement
Les analystes se noient sous les fiches d’incidents. Ceci cherche les motifs qui les traversent et classe ce qui mérite un examen plus attentif, tout en gardant une piste de retour vers les éléments derrière chaque suggestion.
Polices régionales et de petite taille
Les gros contrats d’analyse sont hors de portée de la plupart des budgets. Ceci tourne sur un ordinateur de bureau ordinaire et s’adresse à un analyste seul plutôt qu’à un service entier.
Enquêteurs sur la fraude et la récidive
La fraude à l’assurance et le vol organisé en magasin ressemblent à des incidents sans lien jusqu’à ce que quelqu’un les aligne. Ceci fait l’alignement, et indique où le prochain a des chances de se produire.
Chercheurs qui étudient la criminalité et le maintien de l’ordre
Chaque résultat peut être remonté jusqu’aux enregistrements et aux réglages exacts qui l’ont produit, si bien qu’un autre chercheur peut vérifier le travail au lieu de le croire sur parole.
Chaque piste porte son propre reçu
Enregistrement d’origine, modèle, paramètres, et la transformation à chaque étape. Un visualiseur de journal d’audit est l’une des neuf pages du tableau de bord, pas une demande de fonctionnalité. Pour un logiciel qui classe où va l’attention de la police, c’est le minimum — et c’est la raison pour laquelle le prototype de recherche derrière, ARIA-INTEL, est étiqueté comme n’étant pas prêt pour le même usage.