一个序列模型,它 老老实实地更差
一个建立在完全不同机制上的语言模型 — 比起别人都在用的那套注意力数学,它更接近化学物质在一个表面上扩散。它的表现比 transformer 差,它自己的首页就是这么写的。不是差一点:在标准度量困惑度(PPL)上差四个数量级,基线是生成式预训练变换器 2(GPT-2),而且这话印在本页上,不是印在脚注里。它作为研究日志发布,因为一次被记录下来的失败是有价值的,被删掉的那种没有。
450,000 的训练困惑度,对 GPT-2 的 20,这不是差一点。这是四个数量级,怎么措辞都改不了。
有价值的是那条 E0–E26 的实验阶梯,以及上面标注出来的失败:哪些架构想法垮了、怎么垮的、诊断结果说了什么。一个有记录成因的负面结果是一份贡献。一个被悄悄删掉的负面结果,是把这些工作白做了。
一分钟说清这是什么
几乎所有处理语言的 AI 都建在同一个想法上:让每个词去看所有别的词。它管用。至于其中有多少是因为这是现有最好的想法,有多少只是因为这是大家都试了的那一个,没人知道。
Cell AI 把那个想法拿掉,换上另一个:两种化学物质在一个表面上扩散并反应,就像动物身上长出条纹那样,而且连接是在它读的过程中改变,不是读完之后。然后它按完整规模训练并做了测量。结果比 GPT-2 差四个数量级。这是本页的头条,不是附录里的一行。
想知道没人走的那条路尽头是什么的研究者。已经在给生命系统建模的科学家,因为底下这套机制,正是在化学里造出花纹、在动物身上造出斑纹的那一套。还有教师,因为发表出来的研究几乎全是成功,而一份认真写下的失败记录更少见,也更有用。
架构底下的那套动力学
这是一个 Gray–Scott 反应扩散系统 — 和 CellularPDE 核心所建立在其上的是同一类动力学。两种化学物质以不同的速率扩散并发生反应;投料率和消耗率决定你得到的是斑点、条纹、分裂的细胞,还是什么都没有。这个架构押的注是:这种自组织的场能够承载计算。看着它,自己判断这有多可信。
CellularPDE — 反应扩散核心
在场上点击或拖动,可以注入化学物质 B,扰动这个图案。
分区状态
把这个场分成 N = 4 个分区,和 CellularPDE 核心里一样。高度是每个分区的平均激活;泄漏 λ = 0.01 把它们耦合在一起。
Gray–Scott,Da=1.0, Db=0.5,九点拉普拉斯算子,显式欧拉法。这是动力学基底,不是训练好的模型 — 训练好的模型有 125.8M 个参数,塞不进一个浏览器标签页。
CellularPDE 所建立在其上的那一类动力学。架构本身是 PyTorch。
拿什么取代注意力
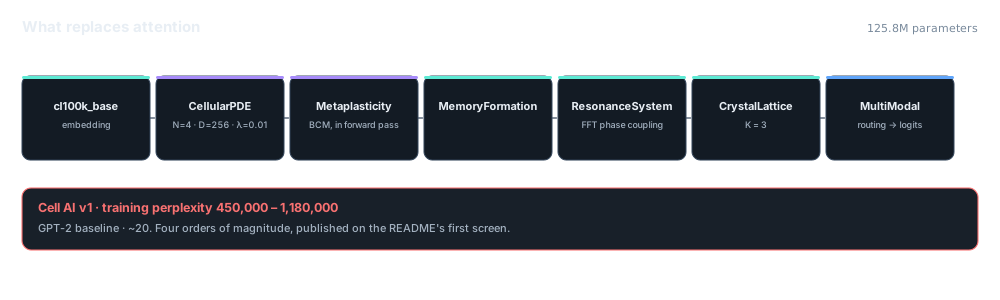
CellularPDE
把 D = 256 维的状态分成 N = 4 个分区,泄漏 λ = 0.01,反应项用 sigmoid — 一个离散的反应扩散系统,站在本该是自注意力的位置上。
MetaplasticityLayer
Bienenstock–Cooper–Munro(BCM)式的赫布学习,α = 0.1,β = 0.01,作用在前向传播 过程中 ,而不是在它之后。这是这个架构里最大胆的想法,也是它那个被记录在案的梯度饥饿问题的来源。
SpectralPDE & SparseHebbian
SpectralPDE 把复杂度从 O(D²) 降到 O(D log D)。SparseHebbian 把更新从 65,536 个权重压到 1,024 个。MultiScalePartitions 跑快慢两条流;AnnealedRouter 用的是 Gumbel-Softmax 调度。
完整的栈
cl100k_base 嵌入 → CellularPDE → MetaplasticityLayer → MemoryFormation → ResonanceSystem → CrystalLattice(K = 3)→ 可选的 Kuramoto 耦合 → MultiModalModel 路由 → logits。共振这一级用快速傅里叶变换(FFT)耦合相位。
E0 到 E26,失败都标注出来
这里真正的产物是那套架构搜索方案。二十七个实验,每个都写了试了什么、出了什么问题,包括那些越做越差的。
| 发现 | 结果 |
|---|---|
| PerFreqResonance | 问题有记录,没做出效果 |
| 路由 | 在某些配置下塌成了类别退化 |
| E26 对 E25 | 回退 — 后做的那个实验更差 |
| ResonanceSystem | 梯度贡献极小 |
| 生成(v1) | 缺少像样的自回归采样 |
| v3 Cell-Fungal Harmonic | 属于推测,未整合 |
那个差距,直说
一次用完全不同的方式造 AI 的实验
今天几乎每一个 AI 都建立在同一个底层想法上。Cell AI 是对另一个想法的一次完整规模的尝试,这个想法借自自然界里图案是怎么形成的 — 发布时失败的部分原样保留。
把目光越过当前路线的研究者
进步需要有人去走那条没人走的路,然后把发生了什么写下来。这就是那次尝试,是完整规模的,而且那些死胡同是被记录下来的,不是被悄悄丢掉的。
为生命系统建模的科学家
底下那套机制,正是在动物身上产生条纹、在化学里产生图案的那一套。如果那就是你工作的世界,这个模型说的是你的语言。
想要一个诚实失败案例的教师
发表出来的研究绝大多数讲的是成功了的事。这是一份关于没成功的事的细致记录,对学习来说,这比再来一个成功故事有用得多。
这些想法后来去了哪里
Cell AI 是那条没有收敛的研究线。它的兄弟项目走得更好:Cypha 成了一套能用的第一性原理架构,长上下文记忆那部分工作则成了统一哈希预测记忆(UHPM)。