Cypha / Ajedrez
Juega al ajedrez contra Cypha
Cypha nunca vio una partida de ajedrez. Aprendió mirando pensar a un programa de ajedrez corriente — 26.568 posiciones, cada una etiquetada con el veredicto del propio programa sobre quién iba ganando — hasta que Cypha pudo producir el veredicto por sí mismo.
Lo que juegas abajo es eso, funcionando en tu navegador dentro de una búsqueda poco profunda. Se le puede ganar, y sigue perdiendo contra el programa del que aprendió. Cada cifra de esta página salió de la ejecución de entrenamiento que produjo los pesos que carga la página.
La raíz del error cuadrático medio (RMSE), abajo, es la medida habitual de cuánto se desvió un conjunto de estimaciones; cuanto menor es, más cerca está el modelo de su maestro.
El R² es contra posiciones reservadas que el modelo nunca vio durante el ajuste. La línea del enfrentamiento es Cypha a profundidad de búsqueda 2 contra el motor maestro a la misma profundidad, con aperturas aleatorizadas y colores alternados. Los cuatro números describen el modelo tal como se destiló — son fijos, y no son mediciones de tu copia.
Ese es el resultado esperado y merece la pena decirlo en vez de esconderlo. La señal es la propia búsqueda a profundidad 2 del modelo, que apenas es más profunda que la vista de la cabeza estática — aprender a estar de acuerdo contigo mismo no es lo mismo que hacerse más fuerte. Mil posiciones frente a las 26.568 con las que se destiló tampoco son nada. La afirmación honesta es que el aprendiz en línea funciona y hace lo que dice; la afirmación de que va a ganar al modelo distribuido no está ganada.
Qué es esto, en un minuto
Todo diseño nuevo de inteligencia artificial (IA) llega con una explicación de por qué debería funcionar. Leer la explicación no te dice nada sobre si funciona. El ajedrez lo zanja, porque la respuesta no es cuestión de opinión: o juega un ajedrez legal y sensato o no, y puedes sentarte a comprobarlo.
Un programa de ajedrez corriente juzga una posición buscando hacia delante entre las jugadas. A Cypha se le enseñaron 26.568 de esos juicios y ajustó una sola fórmula para reproducirlos — una línea de matemáticas sobre 388 números que describen el tablero. No se añadió nada a la arquitectura para el ajedrez. Solo cambiaron los números que se le daban.
Cualquiera que esté valorando Cypha y prefiera comprobar antes que creer. Quienes trabajan con aprendizaje automático y quieren ver a un modelo seguir aprendiendo mientras se usa. Y cualquiera al que simplemente le apetezca una partida — todo funciona en tu navegador, y nada de lo que juegas se envía a ninguna parte.
cypha::Cypha — cabeza de ajedrez aprendiendo
Haz clic en una pieza y luego en la casilla a la que va. Los destinos legales están marcados.
Posición
Lo que Cypha consideró
Jugadas
Aprendiendo de ti
Deriva es el tamaño del cambio en el vector de pesos, respecto al destilado. Última corrección es cuánto se equivocó la cabeza estática sobre la posición desde la que acaba de mover, en peones, medido contra su propia búsqueda más profunda.
Puntuación está en una escalera interna, no en la escala de la Fédération Internationale des Échecs (FIDE) — no hay forma honesta de poner un número FIDE a algo que nunca ha jugado contra un humano con clasificación. El motor de referencia a profundidad 1 se ancla en 1000 y todo se ajusta a partir de 210 partidas por máxima verosimilitud de Bradley-Terry, así que no depende del orden en que se jugaron. La escalera medida: referencia 1000 / 1171 / 1245 a profundidades 1–3, Cypha 798 / 1010 / 1161. Cypha va como una profundidad de búsqueda por detrás del motor del que se destiló, y los márgenes de error son de aproximadamente ±50, que es lo que dan 210 partidas.
Cada ajuste de fuerza mantiene su propio modelo. Una cabeza que juega a profundidad 1 se corrige hacia una búsqueda de profundidad 1; a profundidad 3 el objetivo es otro, mejor. Entrenar los dos en un solo vector de pesos solo haría que discutieran entre sí. Cambia la fuerza y los contadores cambian con ella.
Cómo un motor se convierte en un modelo de Cypha
Esto es destilación de conocimiento, hecha con los mismos componentes que cualquier otra aplicación de Cypha. No se añadió nada específico del ajedrez a la arquitectura — solo las características.
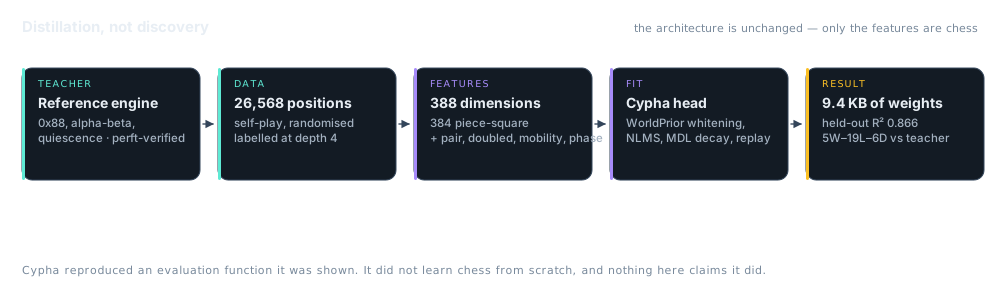
El maestro
Un motor 0x88 con generación completa de jugadas legales, evaluación material y pieza-casilla, ordenación por víctima más valiosa – atacante menos valioso (MVV-LVA) y búsqueda de quiescencia. Verificado contra cinco posiciones perft estándar, kiwipete incluida, así que las reglas son demostrablemente correctas antes de aprender nada de él.
Los datos
Posiciones sacadas de autojuego con aperturas aleatorizadas y ruido deliberado, para que el conjunto abarque partidas reales y no una sola línea estrecha. Cada una va etiquetada con la puntuación de búsqueda del propio maestro, recortada a ±12 peones para que las puntuaciones de mate no dominen.
Las características
388 dimensiones: una diferencia de ocupación pieza-casilla de 384 de ancho (6 tipos × 64 casillas) más pareja de alfiles, peones doblados, movilidad y fase de la partida. Siempre desde la perspectiva del bando que mueve, así que un solo vector de pesos sirve para los dos colores.
El ajuste
WorldPrior θ₀ ajustado en línea con Welford, blanqueo como métrica del gradiente natural, actualizaciones de pesos por mínimos cuadrados medios (LMS) normalizadas, decaimiento por longitud mínima de descripción (MDL) que devuelve los pesos hacia el prior, y un búfer de repetición ponderado por sorpresa en la proporción de referencia 0,30 de Cypha.
El trabajo lo hizo la arquitectura, no el dominio
Cada componente del paso 4 es un componente real de Cypha haciendo su trabajo real. El WorldPrior es la misma gaussiana en línea que le da al clasificador 2-D de la página de Cypha su superficie de decisión. El blanqueo es la afirmación de la geometría de la información hecha concreta: las actualizaciones siguen el gradiente natural y no el crudo. El decaimiento MDL es el prior de Solomonoff expresado como término de contracción.
Lo que cambió para el ajedrez es el mapa de características y la cabeza — regresión en lugar de clasificación. Ese es el argumento que hace el README de Cypha sobre ser un solo tipo que hace varios trabajos, puesto a prueba en un dominio donde la respuesta no es ambigua: o juega un ajedrez legal y razonable o no lo hace.
Los límites honestos
- Es lineal. Una función lineal de características pieza-casilla no puede representar la seguridad del rey, las interacciones de la estructura de peones ni nada que requiera el producto de dos características. Tiene el mismo techo que el README de Cypha describe para el O exclusivo (XOR).
- El maestro es modesto. El motor de referencia es un buscador clásico competente, no Stockfish. Destilarlo bien significa igualar bien a un evaluador modesto.
- Sin profundidad de búsqueda propia. Aquí la fuerza viene sobre todo del envoltorio alfa-beta, exactamente igual que en el maestro.
- Destilar no es descubrir. Cypha reprodujo una función de evaluación que se le mostró. No aprendió ajedrez desde cero, y nada en esta página afirma que lo hiciera.
node tools/chess/perft.js verifica el motor contra las posiciones de prueba estándar, y node tools/chess/train.js regenera el modelo desde cero con una semilla fija. Los números de la parte superior de esta página se leen directamente del archivo que produce esa ejecución.